Pythonで学ぶ監査における統計的サンプリングの背景

はじめに

統計は人類にはまだ早い。

しかしながら、内部統制評価や会計監査では統計学を背景にしたルールが定められていますので、そのため、このブログでは監査で用いられる統計的サンプリングのお気持ちを説明しようと思います。

(1)著者は統計学の専門家ではなくデータサイエンティスト(統計を使う側)の人間です。また、監査から離れて4年経っています。あまり自信がないです。コメントやディスカッション大歓迎です。
(2)ここの記載やプログラムをそのまま実務に用いないでください(責任はとれません)。
(3)専門用語は一般的な言い回しに多少置き換えていますので、特に記述式の試験勉強をしている方はご注意ください。
また、この記事は会計アドベントカレンダー14日目に投稿させていただいています。
adventar.org

Google Colabratoryで動かせるPythonのサンプルコードを提供しています。条件をいろいろ変えて実験してみてください。

colab.research.google.com

この記事はAICPAの"Audit sampling", May 1, 2017; "Audit Guide" (AAG-SAM)の2017年版[1]を元に作成しています。 egrove.olemiss.edu

そのため少し古いかもしれません。(最新のものはお高いです)。本記事では、AAG-SAMの内容を説明しているサブセクションのタイトルに【AAG-SAM】をつけ、本文中では"AAG-SAM \$項番号"で参照します。

目次

※大変長い記事となっています。

1. 統計的サンプリングとは

企業は多くの取引を行いますが、監査は限られたリソースで行う必要があるため、サンプリング(試査)が採用されています。このサンプリングの目的はサンプリングしたレコードを検証して、母集団に関する結論を推測(予測)することです。

監査において統計的サンプリングは主に以下の2つの場面で用いられます。
- 内部統制の運用評価
- 会計監査の実証手続(詳細テスト)

以下では、母集団はN件からなる有限母集団を考えます。サンプルの件数をn件とします。運用評価手続の場合は、監査対象となる内部統制の運用期間中のすべての統制活動、詳細テストの場合は監査対象となる項目のすべてです。ただし、運用評価手続についてはある状況を与えた時に起こりうる統制活動の結果という意味で無限母集団を考える場合もあります。

1.1. 内部統制の運用評価

Aさんが紙で入手した売上伝票を元に、エクセルに転記しているとしましょう。Aさんは当然ミスしてしまう可能性があるため、内部統制として、担当者の転記が正確であるかをBさんがチェックしています。内部統制の運用評価では、Bさんのチェックが有効であるかを評価します。AさんがミスをしてBさんが見落とした場合を内部統制の「逸脱」といいます。このチェックは売上計上額の正確性につながります。売上計上額の正確性のように財務情報の適切性に関する主張(つまり、監査の対象)を「アサーション」と呼びます。

Bさんのチェック作業は年間1000回あるとします。これを全て確認するのは大変なので、例えば、25件サンプリングして確認します。25件の中の逸脱の数から、母集団全体(1000回)の逸脱率が許容できる程度か否かを予測します。この予測結果によって、内部統制が有効であるかを結論づけます。J-SOXやSOX適用の場合、重要な不備は報告することになります。その際には、母集団全体(1000回)の逸脱率そのものを予測して金額的な影響を算定して評価する場合があります。

ちなみに、推測の対象とする逸脱率は、取引ごとの転記作業の間違いやすさ(固有リスク)と正確性のチェック漏れの起きやすさ(統制リスク)を区別しません。どちらに起因しているかを考えず、これらの確率の積を対象にします。また、ひとつのアサーションに複数の統制活動がある場合であっても、結果としてそのアサーションに関してエラーがあるかを対象にします。 一方、統制活動が不確実性を伴って自動化されている場合(AIを利用など)、統制リスクの一部を対象にする可能性も考えられます。例えば、AIのOCRを使った統制活動の失敗率をインプットの特徴の関数として予測しておくことが考えられます。この場合、統制リスクの残りの構成要素や固有リスクを別に評価する必要があります。

キーワード(噛み砕いた説明です)
内部統制の逸脱: 整備された内部統制が正しく運用されなかったケース
アサーション(監査要点): 財務諸表の情報を構成する会計事象で監査の目的になるもの。売上100万円が計上されている場合には、「その売上が実在すること」(実在性)と「金額が100万であること」(正確性)が主なアサーションとなります。

1.2. 監査人による会計監査における詳細テスト

売掛金の金額の正確性を対象に監査するとします。(ここでのアサーションは売掛金の金額の正確性です)。売掛金の金額は売上伝票(紙)の金額が根拠になっています。期末の売掛金が20億円あり、それが200項目から構成されていたとしましょう。200項目すべてを確認するのは大変なので、そのうち35件を確認します。35件のエラーの数から、母集団全体(200項目)の虚偽表示額が許容できる程度か否かを予測します。この予測結果によって、重要な虚偽表示があるかを結論づけます。もし、サンプルの中に虚偽表示が見つかった場合には、母集団全体の虚偽表示額を推定(予測)します。 このように直接根拠資料を確かめる監査手続を詳細テストと呼びます。

内部統制監査と財務諸表監査は、一体で行われることになっています。内部統制が有効であるかの評価結果を考慮して、監査人は監査の範囲を柔軟に決めます。 2つの監査はそれぞれ目的があるものの、依存関係にあります。

キーワード(噛み砕いた説明です)
詳細テスト(Test of Details): アサーションを構成する項目について、その根拠資料やデータを直接検証する監査手続。一方で、データ分析等によって間接的に検証する手法を分析的実証手続(substantive analytical procedures)と呼び、これらを合わせて実証手続と呼びます。

2. 仮説検定について

2.1. 仮説検定は背理法による意思決定

内部統制の運用評価では、n=25件の中の逸脱数から、母集団全体(N=1000回)の逸脱率が許容できる程度か否かを予測します。詳細テストでは35件のエラーの数から、母集団全体(200項目)の虚偽表示額が許容できる程度か否かを予測します。これらは統計的仮説検定という方法によって行います。 仮説検定とはどういう手法でしょうか?

例えば、仲のいい友達と、じゃんけんを10回して、全敗したとしましょう。そんなとき、どう思いますか?
「なぜ?」「そんなに私は運が悪いのか」「友人は小細工をしているのではないか」などなど、いろいろ考えたくなります。「ふつうだったら5勝5敗、運が悪くても3勝くらいはするだろう。それが0勝なんておかしい」と。これが仮説検定の考え方です。

仮説検定では、まず「ふつうだったら、5勝5敗、運が悪くても3勝くらいはするだろう。」という予測をシミュレートします。「ふつうだったら」という仮定を帰無仮説と呼びます。帰無仮説が成り立つ世界ならどうなるかをコンピューターでシミュレーションしてみましょう。

「10回のジャンケン」を10000回シミュレーションして、50%の確率で勝ち50%で負ける場合の勝ち回数の分布を作成してみます。

win_counts = np.random.binomial(n=10, p = 0.5, size=10000)
plt.figure(figsize=(10, 6))
sns.histplot(win_counts, bins=30)
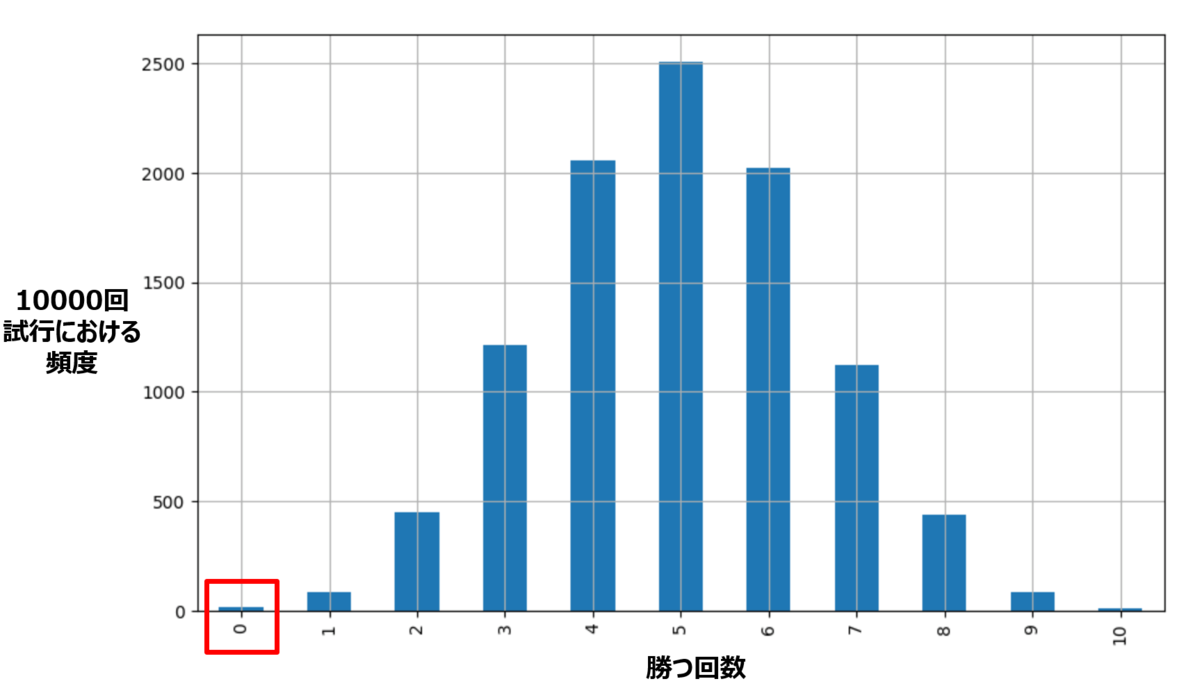
では、今回の結果「全敗」はどうでしょうか。「全敗」の観測度数は図の赤枠の部分に相当します。10000回中、16回で0.16%です。あまりに小さい確率ですので何か細工があると疑いたくなります。 これを帰無仮説を棄却と表現します。「ふつうだったら(帰無仮説に基けば)、5勝5敗、運が悪くても3勝くらいはするだろう。(図のような分布で、3〜7勝くらいに落ち着くことが多い)。それに対して、今回の観測は0勝とあまりにも希少すぎる。これはふつうではない(帰無仮説はおかしいので棄却する)」というロジックです。

 \sqrt{2} が無理数を示すときに敢えて有理数と仮定して矛盾を示すロジック(背理法)と似ていますね。
帰無仮説を棄却して、代わりに採択する仮説を対立仮説といいます。ここでは「友人が小細工していて友人の勝率が高くなっている」です。

キーワード
帰無仮説(null hypothesis): 背理法で主張をするために敢えて仮定される仮説。帰無仮説に基づく分布を帰無分布(null distribution)と呼びます。
対立仮説(alternative hypothesis): 帰無仮説が成り立たない場合に、採択(accept)される仮説。帰無仮説と対立仮説は排反でなければなりません。

2.2. 仮説検定の設計

では、帰無仮説に基づくとおかしいと判断するのは具体的に帰無仮説で何%を切るときでしょうか。例えば、ある人のルールでは帰無仮説に基づくと5%未満の希少な観測の場合には棄却する、別の人のルールでは10%未満といったようにいろいろなルールがあります。ここからは、このルールを測定する話です。

あなたは審判で友人とのじゃんけんに小細工がないかチェックしたいとします。友人は他の人と10回じゃんけんをして、8勝2敗という好成績を残しました。実は友人は「相手の動作や表情筋の動きを観察して次の手を予測していた」とし、真実の勝率が70%だったとします。
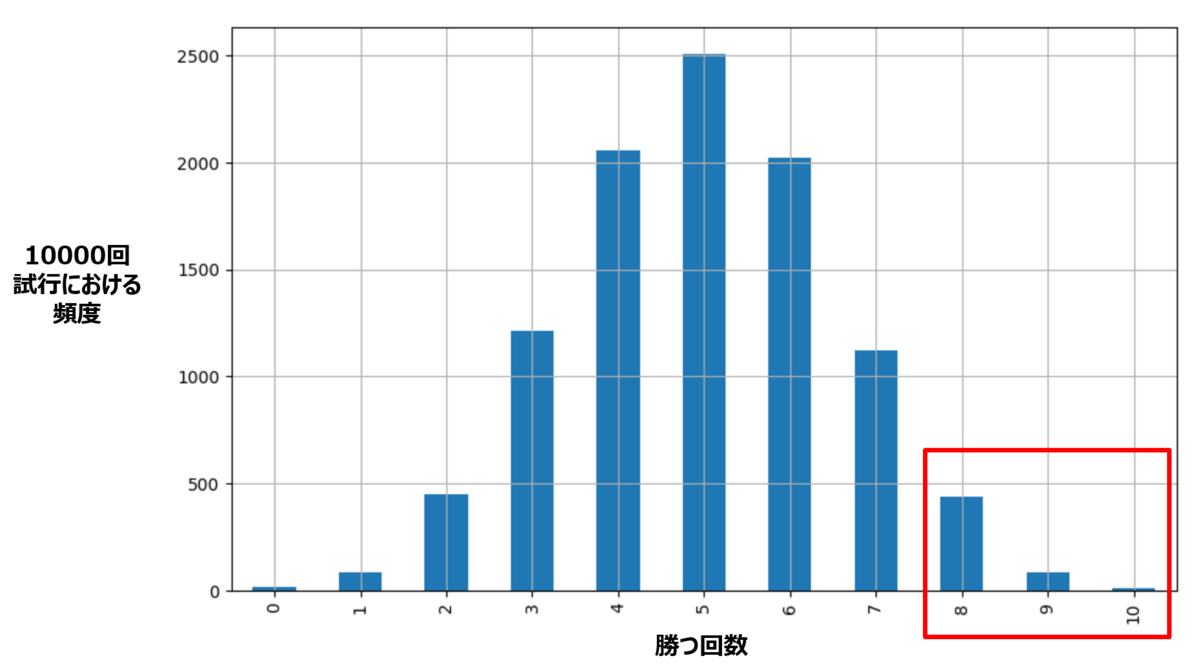
8勝2敗という観測は、帰無仮説(勝率50%)の分布で観測できる確率は16%です。 ここで、何%までを帰無仮説でも説明がつく範囲とみなすか、何%の場合に帰無仮説を棄却するかが問題となります。 例えば、自然科学や社会科学では一般的に5%(両側のため片側は2.5%)が使われています。この閾値を有意水準と呼んでおり、この閾値未満の確率になるような差がある場合を有意差があると呼んでいます。

今回の観測は帰無仮説に基けば16%の範囲なので、有意水準を5%にすると、有意な差はありません。 この場合の結論は、帰無仮説を採択と表現されますが、帰無仮説の内容が正しいと解釈することには問題があります。

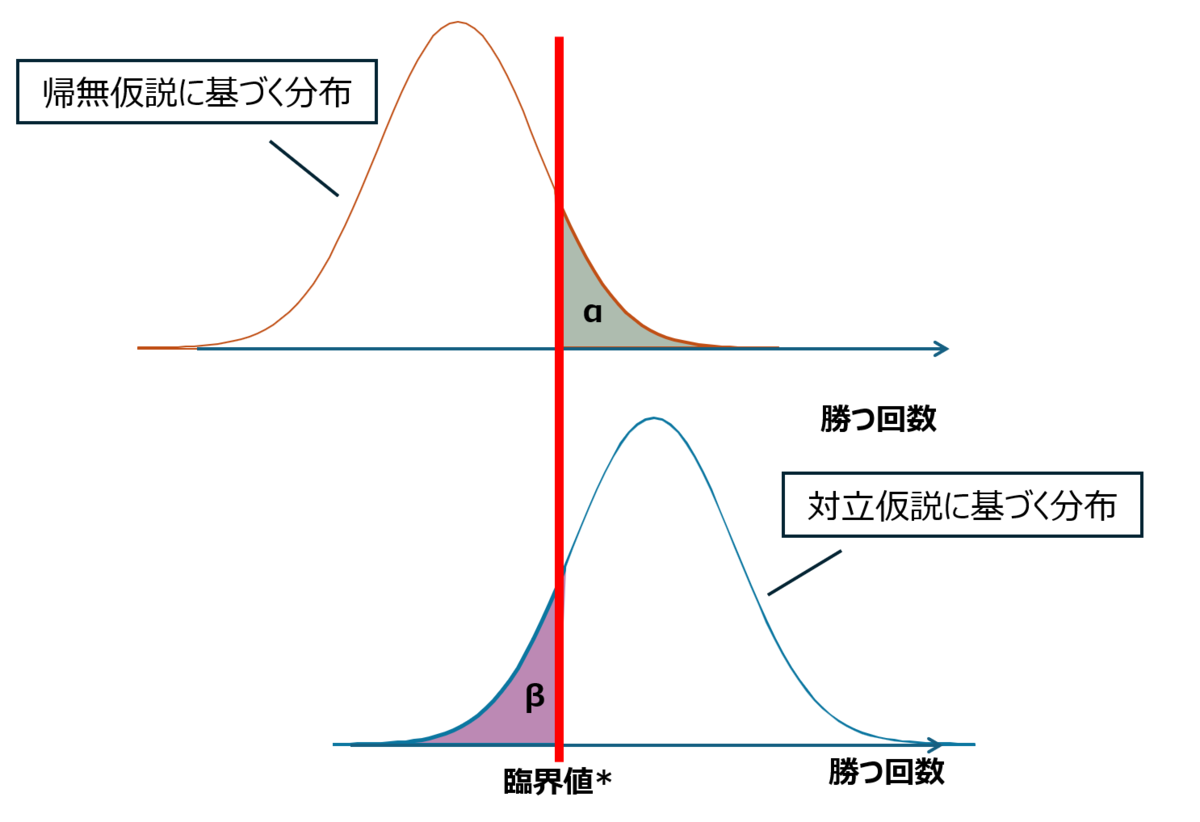
ところで、真実は友人の勝率は高くなっていました。それにもかかわらず帰無仮説を棄却しませんでした。これは真実を知った上で本当は棄却すべきところを棄却できなかったというエラーです。偽陰性(false negative)や第2種の過誤と呼ばれています。 逆に、真実を知った上で棄却してはいけないところを棄却してしまったというエラーは、偽陽性(false positive)や第1種の過誤と呼ばれています。 これらは、2.1.で説明した実際の仮説検定の手続の中ではなく、仮説検定の枠組みに対してどれくらい棄却するか等を測定するときに使われます。

評価対象の仮説検定の枠組みに対して、以下の測定指標があります。
(1) 帰無仮説に基づいて棄却する割合を有意水準(または危険率)とよび  \alpha で表現します。その逆  1-\alpha を信頼度と呼びます。監査サンプリングでは有意水準や危険率よりも信頼度のほうをよく使います。
(2) 対立仮説が真であると仮定して、対立仮説の分布からみたとき、閾値を超えず採択できなかった割合を  \beta で表現します。逆に、採択できた割合を検出力と呼びます。  1-\beta が検出力になります。  \beta よりも検出力のほうをよく使います。

用語がたくさんあってややこしいですね。ちなみに、AAG-SAM $1.28では、 \alpha と \betaを逆に説明して書いており、さらにややこしくなります。何度も読み直したのですが、やっぱり逆のようです。。。また来月読み直してみます。
逆だとすると、帰無仮説を「逸脱が存在しない」、対立仮説を「逸脱が存在する」としてテストを設計していると解釈しているように読めます。つまり、帰無仮説を棄却しないことをもって、有効と意思決定しています。検出力を90%にしているため、「仮にエラーがあるなら90%の確率で棄却できるはず。それが棄却されなかったので問題ない。」という意思決定になります。
全部逆に定義しているだけで、数学的には実質同じ操作ですし、「逸脱の検出」という言葉通りの解釈としてはこちらの方が自然かもしれませんが、統計の使い方としては不自然です。

このブログでは統計学の通り  \alpha を使います。監査サンプリングに関する文献ではAAG-SAMに則って逆にしている場合がある(  \alpha,\beta の文字を逆に当てている場合もある)ため、注意してください。

キーワード
有意(statistically significant):観測の結果、帰無仮説を棄却できる状態。有意かどうかはその効果の大きさ(逸脱がどれくらい少ないか)については何も情報を与えないことに注意してください。
有意水準(level of significance):帰無仮説を棄却する水準で \alpha です。危険率とも呼びます。
偽陽性(false positive):帰無仮説が真であるのに、誤って棄却してしまうこと。第1種の過誤(type 1 error)とも呼びます。
信頼度(confidence):  1-\alpha で、保守性の尺度という意味で信頼度と呼ばれています。信頼係数ともいいます。
偽陰性(false negative):対立仮説が真であるのに、誤って棄却できないこと。第2種の過誤(type 2 error)とも呼びます。
検出力(power):  1-\beta で、対立仮説を仮定したときに、正しく棄却できる確率。
臨界値(critical value):検定したい対象がこの値を超えたら棄却するという意思決定の境界値。正確には検定したい対象を検定統計量に変換して比較する閾値です(本ブログでは変換前に使っています。)。

3. 内部統制の運用評価における統計的サンプリング(AAG-SAMの説明)と諸問題

ここでは内部統制の運用評価を前提に、統計的サンプリングの説明を行います。内部統制の運用評価では、「内部統制の逸脱率が許容できる水準よりも低い水準にあるか」を調べることが目的です。許容できる水準を許容逸脱率と呼びます。帰無仮説として、「内部統制の逸脱率が許容逸脱率以上」である世界を考えます。この許容できる水準を許容逸脱率と呼び、例えば、9%とします。帰無仮説に基づいて25件のサンプリングを10000回試行すると、逸脱件数の分布は次のような図のようになります。
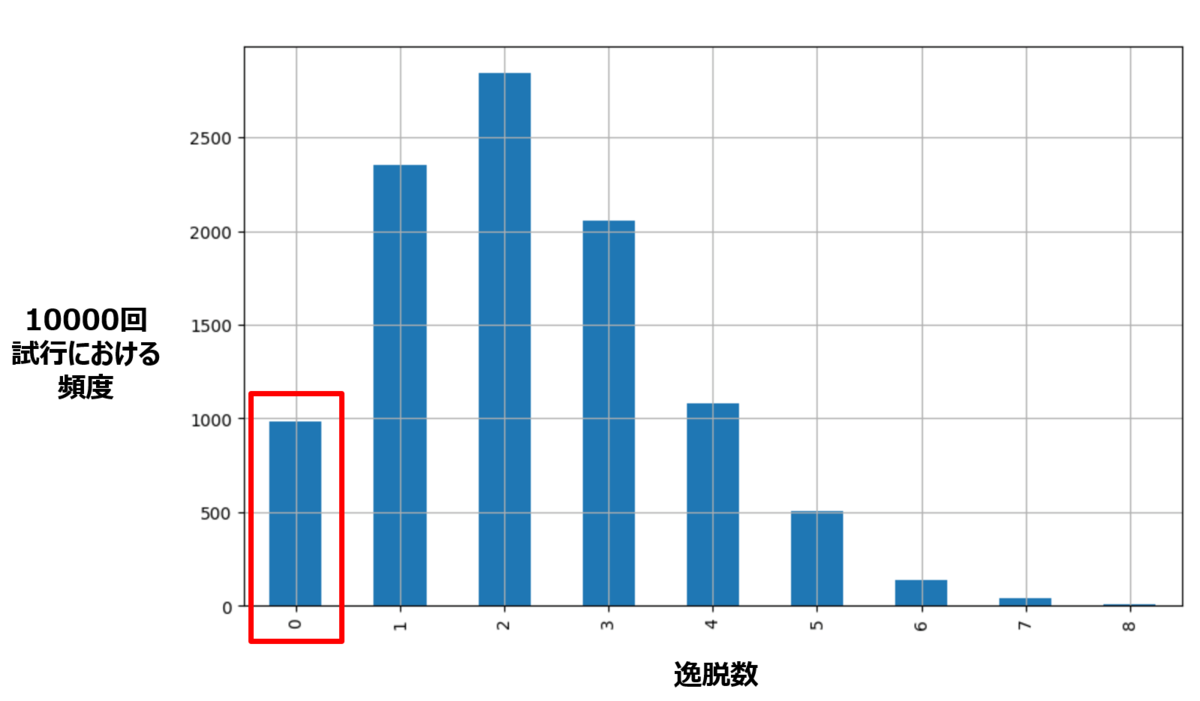
内部統制を実施した証跡を25件確認し、その結果、逸脱は0件でした。帰無仮説に基づくと、これが観測できる確率は図の赤枠部分の度数に対応し約9.4%です。10%未満のため帰無仮説を棄却し、許容逸脱率よりも小さいと結論づけることができます。

3.1. 【AAG-SAM】25件の背景

では、このサンプルサイズ(25件)はどのように決まっているのでしょうか。統計的サンプリングにおける仮説検定の設計では信頼度を重視しています。信頼度は保守性の尺度であるため、監査の見落としを防ぐために重要となります。
一方で、検出力は真の逸脱率が許容逸脱率より小さかった場合に、許容逸脱率と変わらないと結論づけてしまう割合のためここでは考慮されていません。なぜなら、仮にそうであっても、実証手続でカバーできるからだそうです。(AAG-SAM $3.39に詳細テストを増やせば問題ないと書いてあり、財務諸表監査との一体監査を前提としていることがわかります。でも内部統制監査だけの報告ってありますよね)。
検出力を考えない代わりに、想定する観測と信頼度条件を満たす中で、サンプルサイズをできるだけ小さく設定しています。

想定する観測として、どのような観測を前提にしたいでしょうか。一番良いストーリーはn件調査して逸脱が0件だったときに、帰無仮説が棄却できることです。許容逸脱率:q=9%、信頼度:  \alpha=90%と設定してこのようなサンプルサイズを計算してみましょう。
帰無仮説に基づいて逸脱がないレコードをn件を観測する確率は  (1-q)^n です。これが  \alpha よりも小さいと棄却できます。 すなわち、  (1-q)^n \leq 0.1 となります。変形すると  n \geq \frac{\log(\alpha)}{\log(1-q)} ですので、  \alpha と  q を代入して、これを満たす最小のnは25件となります。

分布をシミュレーションして計算することもできます(上記は予想逸脱数が0の場合で、予想逸脱数が0でない場合は解析的に解けずシミュレーションによることとなります)。 nを減らすほど有意水準  \alpha が単調増加していくことを前提に、  \alpha で棄却できる条件を満たせる限りnを減らしていき、満たせなくなった場合のnに1増やしたものとして、最小のサンプルサイズを計算できます。

tolerable_rate = 0.09
expected_deviation = 0
confidence = 0.9
n = 1000
while binom.cdf(k=expected_deviation, n=n, p=tolerable_rate) < (1 - confidence):
    n = n - 1
print(n + 1)

ちなみに、なぜ母集団のサイズが100件でも100万件でも25件で良いのかもやもやする方もいらっしゃると思いますが、比率について推測しているからと考えると納得できるかもしれません。

この(25件、信頼度10%、許容逸脱率9%)条件について、実は、このうち(25件、信頼度10%)は内部統制実施基準[4]に記載されています。そして、AAG-SAM $3.42でも内部統制に依拠するには90-95%の信頼度が採用されるだろうと記載しています。
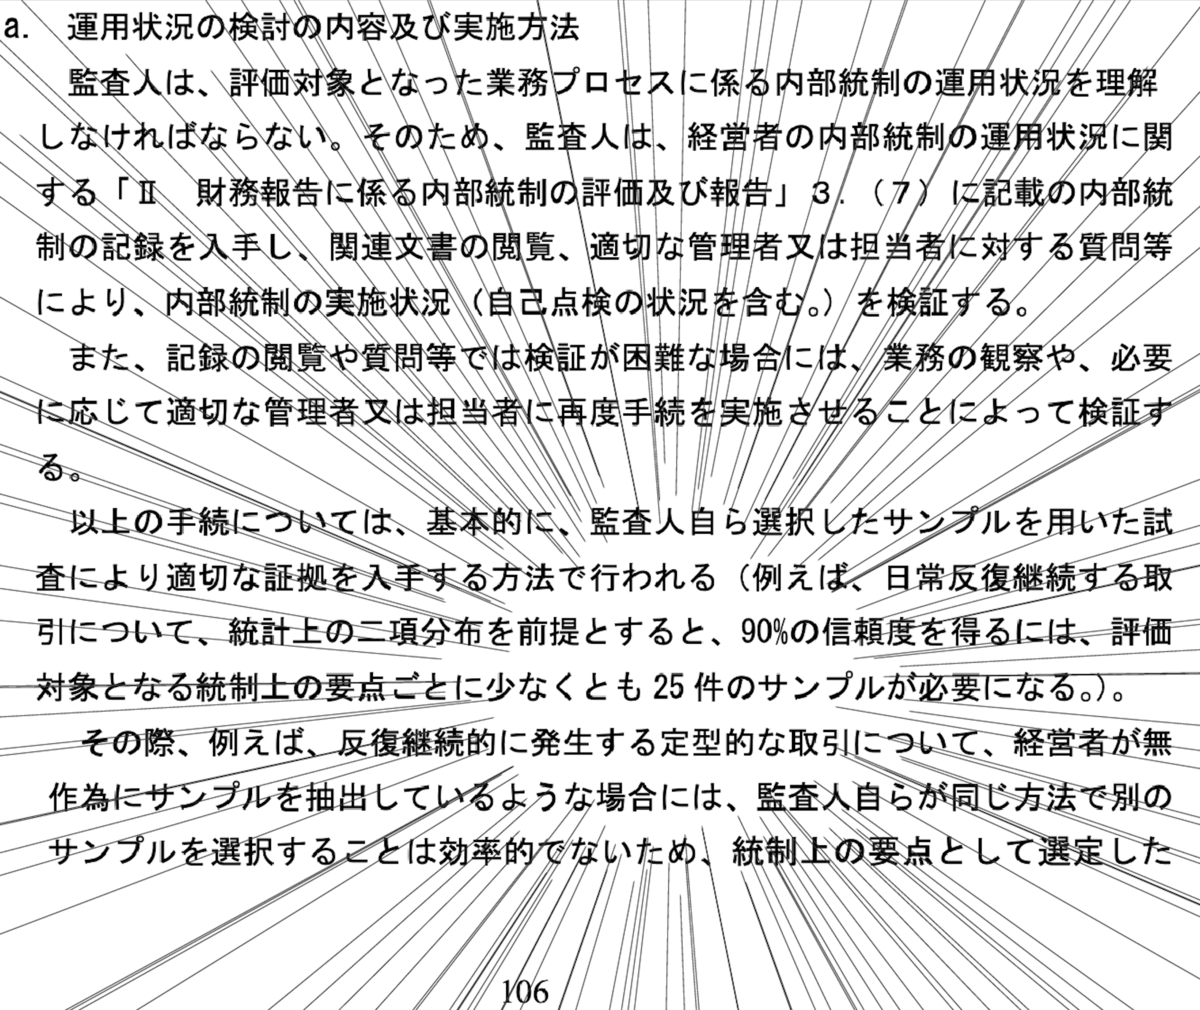
「財務報告に係る内部統制の評価及び監査の基準並びに財務報告に係る内部統制の評価及び監査に関する実施基準(令和5年4月7日時点)」[4]の一部改変

一方で、許容逸脱率については直接記載がありません。内部統制実施基準[4]では信頼度10%で少なくとも25件と記載しているので、逆算すると許容逸脱率9%を前提にしていることになります。(「少なくとも」というのは予想逸脱率が0%の場合と解釈しています。)AICPAやPCAOBの基準では許容逸脱率(あるいは上記のようなサンプルサイズと信頼度の組み合わせ)への言及はありませんでした。ただAAG-SAM Table 3-1では1%, 5%, 10%を掲載しており、この範囲が想定されていると解釈することはできます。ちなみに、Durney et al., (2013)[5]によると(日本以外だと思いますが)法人によっては9%でないところもあるようです。ヒアリングした中での最大は10%だそうです。

信頼度90%ということは、10回やったら期待値1回は見落とすレベルです。これを多いと思うか少ないと思うか。しかし、実務的に資料を揃えてもらってテストするとなると25件は限界に近いのではないかと思います。逆に監査で見落としてしまうリスクが高くなるという実務的な制限も考えて決めていかないといけません。

キーワード
許容逸脱率(Tolerable rate of deviation): 内部統制で許容される逸脱率で、これを帰無仮説の逸脱率にして帰無分布をつくり、実際に観測した逸脱数からこの逸脱率より小さいと主張します。
予想逸脱率(予想逸脱数)(Expected population deviation rate) : サンプルサイズを小さくするために、この逸脱率(逸脱数)が観測されたとしても帰無仮説が棄却できるとする値です。
実際の逸脱率(逸脱数): サンプルを検証して実際に観測した逸脱率です。帰無仮説に基づきこの逸脱率(逸脱数)が稀であれば棄却できます。

3.2. 帰無仮説の前提

サンプルサイズ25件(信頼度0.9、許容逸脱率9%)の前提では、
(1) 逸脱がある請求書か逸脱がない請求書かのどちらかが観測でき(ベルヌーイ試行)、(2)各試行は独立で、(3)取り出した請求書は元に戻す復元単純無作為抽出を考えています。

(1) 逸脱があるかないかの2択なので、"軽微な"逸脱は想定していません。端数がずれているといった少しでも誤りがあれば逸脱とみなします。
(2) 各試行は独立というのは請求書を順番に取り出す試行をするとき、すべての試行が互いに影響しないことです。
例えば、「すべての子会社の請求書を母集団にして、子会社Aの資料を取り寄せたので、子会社Aから3つくらいサンプリングしておく」というのは、3つのサンプリングの試行が独立ではありません。「十分にシャッフルされていない請求書の束から10枚おきに取得する」といった場合でも、直前に取り出した請求書とダンボールに入れられたタイミングが近い請求書が次に取り出される傾向があるため独立とはいえません。

(3) 復元単純無作為抽出を仮定しています。
取り出した請求書は元に戻す復元単純無作為抽出については、実際には取り出した請求書は元に戻さない非復元単純無作為抽出を行なっているため、乖離があります。しかし、非復元単純無作為抽出を前提にしても、復元単純無作為抽出を前提にした場合とほとんど同じ(少し保守的)であるため問題ないとされています。母集団のサイズNが取り出す標本サイズnに対して大きくなればNがN-nになる影響は小さくなることが想像できます。一方で、教育的な理由を除けば、計算パワーに困らない現代では超幾何分布で計算すれば良いと思います。
次のコードで有限母集団のサイズNがN=800の場合は25件ですが、小さくすると変わってきます。Nが小さい場合は2項分布は超幾何分布の良い近似にはなりません。N=54(週次程度)の場合はn=23件、12(月次程度)の場合は11件です。ちなみに、AAG-SAM \$3.63 Table 3-5に母集団サイズが小さい場合のサンプルサイズが載っていますが、これよりだいぶ少ないです。

tolerable_rate = 0.09
expected_deviation = 0
confidence = 0.9

N_all = 800
n = N_all # initial

while hypergeom.cdf(k=expected_deviation, M=N_all, N=n, n=math.floor(tolerable_rate*N_all)) < (1 - confidence):
    n = n - 1
print(n + 1)

キーワード
ベルヌーイ試行(Bernoulli trial): 結果が成功か失敗かの2値のみをとる試行。
復元単純無作為抽出(sampling with replacement): サンプルを取り出した後、母集団に戻してから次のサンプルを取り出す方法。各試行は独立になります。
非復元単純無作為抽出(sampling without replacement): サンプルを取り出した後、母集団に戻さずに次のサンプルを取り出す方法。各試行は独立ではなくなります。
超幾何分布(hypergeometric distribution): 非復元抽出における成功回数の確率分布。母集団サイズが小さい場合、2項分布よりも正確です。
2項分布(binomial distribution): 復元抽出における成功回数の確率分布。各試行が独立なベルヌーイ試行をn回繰り返したときの成功回数の分布です。

3.3. 25件の検出力

「予想逸脱数0件/25件でテストしてたまたま逸脱が1件見つかってしまいました。」というケースです。あるあるですよね。"あるある"の理由は25件の設計における検出力にあります。例えば、真の逸脱率は3%として、予想逸脱数0件で逸脱率9%の帰無仮説を棄却するためにサンプルサイズを25件としました。仮に、対立仮説が真である前提で、逸脱率3%に基づいて25件抽出し、逸脱が1件以上ある確率を計算してみると52%もあることがわかります。

print(
    sum(binom.rvs(n=25, p=0.03, size=10000)>0)/10000
    )
#> 0.5269

このように、25件の設計では、「本当は十分小さい逸脱率なのに、棄却できない」というケース(偽陰性)はかなり多く発生することがわかります。この例では検出力は47%と小さいです。というのも、内部統制の運用評価におけるサンプルサイズ決定では検出力(あるいは  \beta )を無視しており、予想逸脱率に基いで、ぎりぎり棄却できる最小のサンプルサイズとして選んでいるからです。攻めの監査です。

ではどうすればよいでしょうか。そもそも、25件の前提は予想逸脱数0件の場合でした。予想逸脱数を1件にしてみましょう。 するとサンプルサイズは42件となります。逸脱率3%で42件抽出した場合に逸脱が2以上ある確率を計算してみると35.8%に減り、検出力は64.2%へと改善しました。

print(
    sum(binom.rvs(n=42, p=0.03, size=10000)>1)/10000
    )
#> 0.3644

このように、事前にある程度の逸脱が想定できる場合には、予想逸脱数を0にしないことが重要です(事前に想定するのが難しいとは思いますが...)。
一方で、予め欲しい検出力を満たすようにサンプルサイズを決めることもできます。検出力は対立仮説に基づいて計算するため、対立仮説における逸脱率を何%として計算するか決める必要があります。先ほどの例のとおり3%として計算してみます。

from scipy.stats import norm
def required_sample_size(p0, p1, alpha=0.05, power=0.8):
    z_alpha = norm.ppf(1 - alpha)
    z_beta = norm.ppf(power)
    n = ((z_alpha * np.sqrt(p0 * (1 - p0)) + z_beta * np.sqrt(p1 * (1 - p1))) / abs(p1 - p0)) ** 2
    return int(np.ceil(n))

required_sample_size(tolerable_rate, true_deviation_rate, alpha = 1-confidence, power = 0.8)
#> 73

この場合、検出力80%を満たすようにするには72件必要になります。

3.4. 逸脱率の状況依存性

内部統制の逸脱率は検証対象とする評価範囲における平均的な逸脱率として評価されます。例えば、内部統制の担当年数が10年のAさんが4〜9月の200件を担当し、10月以降の200件は新人のBさんが担当した場合、内部統制の逸脱率はAさんとBさんが半々で作業した場合として評価されます。内部統制だけの評価としてはそれで良いと思うのですが、問題は、財務諸表監査において内部統制に依拠するかの意思決定で生じます。
内部統制の運用評価ではAさんとBさんが半々で行っていたため逸脱率が許容逸脱率よりも十分低かったものの、期末の残高を構成する取引に対してはほとんどBさんが担当していて、逸脱率が内部統制で評価した逸脱率よりも増加しているという状況になります。このとき、内部統制の評価を根拠に依拠できると意思決定をして、実証手続を緩めると(詳細テストを少なくすると)、結果的に監査リスクが大きくなってしまいます。
他に考えられる例としては、複数の事業拠点の統制活動を一括で評価している場合です。事業拠点によって逸脱率が異なり、それらが会計残高を構成する割合は変化しやすいです。
これらの例以外にも、多様な取引や業務フロー、統制活動を行う人の状況など、さまざまな要因に逸脱率が依存していて、内部統制評価時と会計監査時で乖離してしまう可能性があります。

対策1: 母集団の層化

構成比の変化に対してロバストにするには母集団をグループに分割して部分母集団にしておくことです。グループは似たようなものを集めるのではなく、可能であれば逸脱率に影響する変数が似ているようなものを集めることが望ましいです。
「統計的サンプリングでは母集団が均質でなければならない」という言説を見かけます。ここでいう均質は変数の値のばらつきが小さいということと解釈しています。変数が逸脱率に影響するかわからなかったとしても、すべての変数を観測しグルーピングすることができれば、対策になります。

母集団の層化は、サンプルの観測から母集団の推定したいものを推定する(点推定や区間推定)のであれば、母集団の推定量の分散を小さくできるといったメリットがあるものの、内部統制の運用評価では基本的には仮説検定を行うのみなのでそのようなメリットはありません。むしろ、均質化は状況依存性への対策として重要なのではないかと考えています。

対策2: 状況依存性を特定し、リスクをモデリングする

逸脱率に関係する変数を使用して、変数別の逸脱率(条件付き逸脱率)の予測を行います。例えば、経験豊富なAさんの統制活動を経た取引の重要な虚偽表示率は5%、Bさんの場合は10%、のように変数によって変化する逸脱率に対して機械学習モデルをフィッティングします。
期末の残高を構成する取引に対して逸脱率を予測することで、状況依存性の変化に対応できます。このアプローチは多くのサンプルを必要とするため現状の業務では難しいかもしれませんが、AI等による統制活動の自動化の暁には現実的になります。

例外的な事象について

経済状況の変化が大きいと、想定外の業務フローが発生し、統制活動が適切に行えないケースが出てきてしまうと思います。このような例外的な事象は数多く考えられるものの、ひとつひとつが顕在化する可能性は小さいという厄介な性質があります。そして、たいていの場合、1年間という評価期間は、例外的な事象の発生確率を推定するのに十分ではありません。例外的な状況に依存して逸脱率が大きく変化するものの、その変数を観測できていない(外挿)問題になります。
このようなケースでは例外を含まない前提における内部統制の評価に依拠することはできません。企業の状況をよく観察したり、観測できる変数の分布外検知(異常検知)を行ったりすることで、例外的な事象が生じていないかに注意する必要があります。

3.5. 帰無仮説を棄却できない場合の取り扱い

「予想逸脱数0の前提でサンプルサイズ25件を設定してサンプルを検証した結果、棄却できませんでした。予想逸脱率を修正して再度検定していいですか?」という問題を扱います。ここではあくまでサンプルサイズ上の扱いに限定します。
監査サンプリングでは逸脱が見つかった場合に、サンプリング範囲を拡大できることがAAG-SAMに記載されています。一方で、同じ検定を複数回行いどれかが棄却できた場合に全体で棄却できたとするのは多重比較と言われています。逸脱が見つかった時にサンプリング範囲を拡大することは、多重比較になるのでしょうか。

結論としては、多重比較になるが、影響はそこまで大きくないです。基本的に当初に計画した棄却条件を変える場合、信頼度は保証されません。棄却条件の変更を認める計画にした場合にどの程度の信頼度になるかはシミュレーションできます。

信頼度は帰無仮説に基づいて計算します。例えば、許容逸脱率9%として25件のサンプルの逸脱数0件だった場合に棄却する計画では50000回中4721回棄却されました。つまり \alpha=9.44\%で信頼度は 1-\alpha=90.56\%となります。

# 帰無仮説に基づき25件中0件を観測する確率
tolerable_rate = 0.09
n = 50000
judge_list=[]
for itr in range(n):
  error_num = binom.rvs(n=25, p=tolerable_rate)
  judge_list.append(error_num==0)

print(sum(judge_list)/n)
#> 0.9442

では、25件サンプリングして、最初の10件を見たところ虚偽表示が見つかってしまったので、再度25件サンプリングし直した場合を考えます。それを認める計画でシミュレーションすると \alpha=15.43\%、信頼度は 1-\alpha=84.57\%となります。当初の計画である信頼度90%より低下してしまいます。

# 最初の10件で棄却できなかった場合に25件取り直す方法で、帰無仮説で最終的に棄却できる確率
tolerable_rate = 0.09
n = 50000
judge_list=[]
for itr in range(n):
  error_num = binom.rvs(n=10, p=tolerable_rate)
  if error_num == 0:
    error_num_add = binom.rvs(n=15, p=tolerable_rate)
    judge_list.append(error_num + error_num_add==0)
  else:
    error_num_ret = binom.rvs(n=25, p=tolerable_rate)
    judge_list.append(error_num_ret==0)

sum(judge_list)/n
#> 0.15272

AAG-SAM $3.84 には、予想した逸脱を超える虚偽表示が出てしまった場合には、サンプルサイズを倍に増やせば、保証水準を同等がそれに近い水準で結論をくだせるだろうという記載があります。 25件を前提に、この計画の信頼度を計算すると88.32%です。そのため、90%に近い水準というのは嘘ではないです。

# 25件で棄却できなかった場合に50件に拡大して合計1件であれば棄却する方法で、帰無仮説で最終的に棄却できる確率
tolerable_rate = 0.09
n = 50000
judge_list=[]
for itr in range(n):
  error_num = binom.rvs(n=25, p=tolerable_rate)
  error_num_add = binom.rvs(n=50-25, p=tolerable_rate)
  judge_list.append((error_num==0)|(error_num + error_num_add ==1))
sum(judge_list)/n
#> 0.11468

ちなみに、詳細テストについては$4.95に件数拡大の旨、$4.97に2倍という経験則の記載があります。

信頼度90%は何かに規定されているわけでもなく、そこまで下がっていないので良いと考える人もいるかもしれません。初めから信頼度88%の前提でルールを作っておけば問題ないです。
しかし、保証水準として決めている以上、やはり90%は確保したいですよね。であれば、初めから予想逸脱率がある程度あってもいいようにサンプルサイズを設定すべきなのですが、25件程度で済むならそうしたいですよね。
そのような場合、あらかじめ多段階のテストを行なう計画を最終的に  \alpha が0.1になるように設計できます。例えば初めに26件サンプリングしてもし1件逸脱が見つかったら合計60件になるように追加サンプリングする計画であれば、信頼度は90%を満足できます。 今回は2項分布の確率質量関数を使って正確に計算します。計算すると90.49%となります。

# 26件で棄却できなかった場合に60件に拡大して合計1件であれば棄却する方法で、帰無仮説で最終的に棄却できる確率
tolerable_rate = 0.09
n = 26
p_k0_n1 = binom.pmf(k = 0, n = 26, p = tolerable_rate)
p_k1_n1 = binom.pmf(k = 1, n = 26, p = tolerable_rate)
p_k0_n2 = binom.pmf(k = 0, n = 34, p = tolerable_rate)
print("危険率 = ",p_k0_n1 + p_k1_n1 * p_k0_n2) #> 0.095
print("信頼度 = ",1-(p_k0_n1 + p_k1_n1 * p_k0_n2))#> 0.904

一般的な計画を作成する手法として、α消費関数法が知られています。例えば、O'Brien Flemingの方法では、全体でn件でテストするときに、そのうちの割合qに相当するqn件で中間テストを実施する場合、中間テスト時点で消費する危険率は  2-2\Phi(\frac{z_{\alpha}}{\sqrt{ q }}) となります。  \Phi は累積標準正規分布、  Z_{\alpha} はその片側  \alpha\% 点です。しかし、この手法は保守的になってしまうのと、内部統制の逸脱数は離散的に増えていくので、初めからシミュレーションする方が良いと思います。

ちなみに、このような多段階計画はAAG-SAM "Appendix B Sequential Sampling for Tests of Controls"で説明されており、AAG-SAM $3.64では計画時にsequential sampling planを選択することも想定されています。

多段階をもっと一般化すると、1件ずつサンプルを確認して条件を満たしたら停止するような計画を作ることができます。このような計画は逐次計画といいます。統計的サンプリングの逐次計画は今年のSIGFINで発表がありました[6]。監査サンプリングも進化し続けています。

www.jstage.jst.go.jp

3.6. 【AAG-SAM】帰無仮説を棄却できない場合の逸脱率の推定

内部統制の運用評価において、帰無仮説を棄却できない場合、AAG-SAM $3.85 によると内部統制の欠陥と評価し、その重要性を判断します。その際に、手元のサンプルの観測から逸脱率の推定を行います。

今、手元に25件のサンプルがあり、2件の逸脱があったとします。許容逸脱率9%、信頼度90%で計画していたため、帰無仮説を棄却できませんでした。このとき、25件の観測から逸脱率を2/25=8%と推定できます。これは、標本比率で点推定(真ん中の予測)を行なったものです。一方で、監査では母比率のとりうる範囲(特に上限)を知りたいと考えます。母比率のとりうる範囲は区間推定によって予測できます。

区間推定は「仮にその区間を帰無仮説の棄却域としたとき、新たにデータを取った時に信頼度  \alpha で棄却されない区間」として計算することができ、その精度をカバー率で測定すると、(分布等の仮定が正しければ)信頼度  \alpha の確率で母比率をカバーできます。監査における逸脱率の推測では信頼区間の上側が欲しいため、上側片側として推定します。

AAG-SAM $3.77とTable A-3, A-4では母比率の区間推定を用いて上限を推測しています。n件の観測のうちx件の逸脱があった時のClopper-Pearsonの片側上側信頼限界は  Beta(1-\alpha;x+1,n-x) で計算できます。例えば25件中2件の逸脱があったとき90%片側上側信頼限界は19%となります。この逸脱率上限19%をもとに、金額的重要性の評価や監査リスクのコントロールを行うことができます。

confidence = 0.9
n = 25
deviation_num=2
beta.ppf(confidence,deviation_num+1,n - deviation_num)
#> 0.199

キーワード
点推定(point estimation): 母集団のパラメータ(逸脱率など)を1つの値として推定すること。標本比率による推定は点推定の一例です。真ん中の予測とごまかしていますが、真ん中の定義にはいろいろあり、例えば推定量の期待値が真の値になる(バイアスがない)という普遍性があります。
信頼区間(confidence interval): 「仮にその区間を帰無仮説の棄却域としたとき、新たにデータを取った時に信頼度  \alpha で棄却されない区間」として計算することができ、その精度をカバー率で測定すると、(分布等の仮定が正しければ)信頼度  \alpha の確率で母比率をカバーします。サンプルを観測して計算した信頼区間は推定値(くじ引きを引いた結果の一つ)なので、その区間が真の値を含んでいるか否かは何も言えないことに注意してください。また、分布等の仮定が正しければというのも、一つの推定量に対しても信頼区間の作り方にはいろいろあり、それらは分布を仮定する場合が多く、仮定と現実が乖離していると現実ではカバー率を満たしません。
片側上側信頼限界(one-sided upper confidence bound): 信頼区間の上側のことで、推定上限逸脱率の算定に使います。

3.7 逸脱率のベイズ統計モデリング

これはAAG-SAMに記載がない方法ですが、ベイズ統計モデルによる推定を紹介します。
ベイズ統計モデルでは、予測したい対象である逸脱率について、事前情報を元に初期の分布(事前分布)を設定し、それを観測したデータに当てはまるように更新します。更新した後の分布を事後分布よび、これに基づいて予測を行うことができます。事後分布は事前分布に(観測したデータの)尤度を乗じることで計算できます。

 \displaystyle
p(\theta|y)\propto p(y|\theta)p(\theta)

仮に、前期までの内部統制で合計60件のうち3件の逸脱があったとします。事前分布を  a_{p}=3,\beta_{p}=57 のベータ分布と仮定します。すると2項尤度(25件中2件の逸脱)で更新すると

 \displaystyle
p(\theta|y)\propto \theta^{y}(1-\theta)^{N-y} \theta^{a\_{p}-1}(1-\theta)^{b\_{p}-1}

となります。これは以下のようにまとめることができて

 \displaystyle
p(\theta|y)\propto \theta^{a\_{p}+y-1}(1-\theta)^{b\_{p}-1+N-y}

規格化定数を確率が1になるように調整することでパラメータを更新したベータ分布で表現できます。

 \displaystyle
p(\theta|y)= Beta(a\_{p}+y, b\_{p}+N-y) = Beta(3+2,57+25-2)

事後分布から片側上限信用限界を計算すると9.29%となります。

beta(3+2, 57+25-2).ppf(0.90)
#> 0.0929

ベイズモデルの良い点として、他の変数や人間の知識との統合が容易に行える点があります。例えば、サンプルに金額、取引タイプ: a, b, c、作業担当者: A, B, C、作業時間: 午前, 午後のような特徴量があったときに、特徴量と逸脱率の関係を反映した階層ベータ分布としてモデルを作成できます。なお、先ほどの例では事後分布がベータ分布になることが分かっていたため、パラメータの更新のみで計算できましたが、階層化等をするとシミュレーション計算が必要になります。 (取引タイプ:b, 担当者:B, 作業時間:午前, 金額:平均値)の場合の90%上限は18.84%のように、条件別に計算できます。
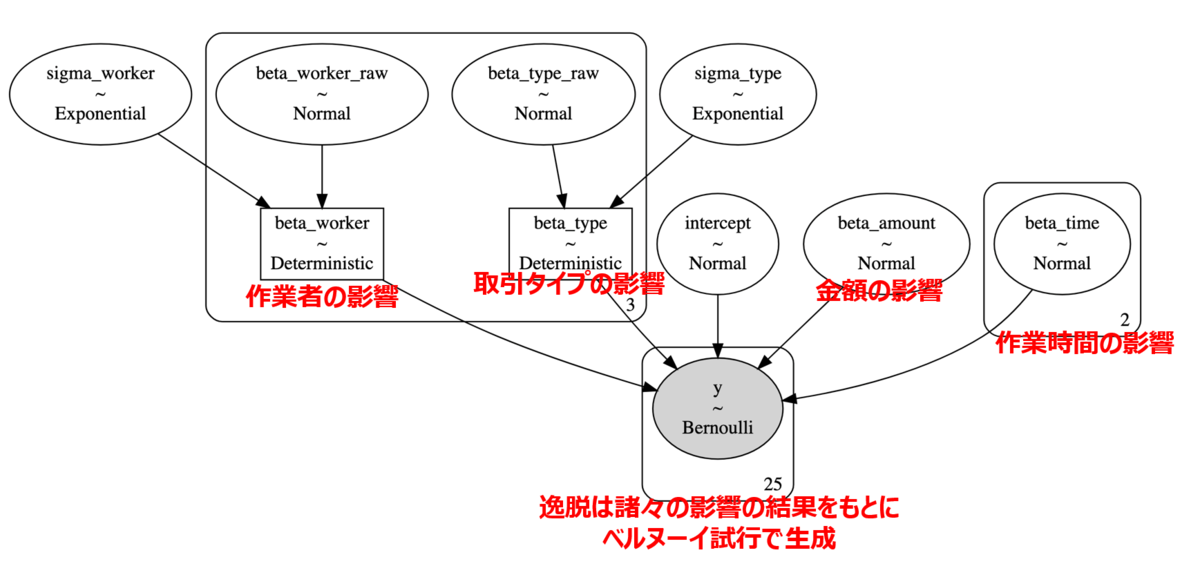
キーワード
事前分布(prior distribution): データを観測する前の、パラメータに関する初期の信念や知識を表す確率分布。
事後分布(posterior distribution): 観測データによって更新された、パラメータに関する確率分布。事前分布に尤度を乗じて計算されます。
尤度(likelihood): あるパラメータの値の下で、観測データが得られる確率(または確率密度)。
信用区間(credible interval): ベイズ統計における区間推定。事後分布においてパラメータ含まれる区間を予測したもの。頻度論の信頼区間とは解釈が異なります。
規格化定数(normalization constant): 確率分布の総和(または積分)を1にするための定数。

4. 詳細テストにおける統計的サンプリング(AAG-SAMの説明)と諸問題

AAG-SAMでは詳細テストのサンプルサイズの計算として、金額単位抽出とClassical variables samplingの2つの方法を紹介しています。

4.1. 【AAG-SAM】方法1: 金額単位抽出における詳細テストのサンプルサイズ【修正予定】

<追記 2026/08/07> こちらの訂正部分は金額単位抽出の設計を考慮できていませんでした。修正したブログを作成予定です。

詳細テストでは内部統制の運用評価の"25件"のように、日本の公式の例示がないため、AAG-SAM $6.20に記載されている数値例を元に説明します。母集団金額(20億)のうち5%の金額が許容できる虚偽表示額(6000万)とします。つまり金額の許容虚偽表示率が5%です。信頼度90%が要求されており、予想虚偽表示率が1%としましょう。詳細テスト(金額単位抽出)では、金額と虚偽表示率は独立という仮定を置いて計算しています。
レコードiの虚偽表示額が  Y_{i}=M_{i}\tau_{i} とかけると仮定します。  M_{i} は帳簿価額、  \tau_{i} は虚偽表示である割合で0または1をとるものとします(精緻にモデリングする際には0〜1にします。)。
虚偽表示額の合計は  \Sigma_{i \in B}M_{i}\tau_{i} ですが金額と虚偽表示であるかは独立なので期待値の積にできます。すなわち

 \displaystyle
N\frac{1}{N}\Sigma_{i \in B}M_{i}\tau_{i} = N E[M_{i}]E[\tau_{i}]

平均簿価は母集団のすべてのレコードで観測して計算すればよく、結局  E[\tau_{i}]、つまり虚偽表示の件数がわかれば良いことになります。
帰無仮説を「虚偽表示が5%以上である」とします。また、母集団全体の虚偽表示が5%の時、サンプルn件に含まれる虚偽表示の数が 5n%件のポアソン分布になると仮定します。(運用評価と同様に2項分布を用いた方が解釈しやすいのですが、ここではAAG-SAMに基づきポアソン分布とします。)
すると予想虚偽表示率1%の通り虚偽表示が見つかった場合に、棄却できるようにするには、この分布の10%(1 - 90%)に収まれば良いので、

 \displaystyle
e^{-\lambda n} \lt 0.1

これを満たす最小のnは47です。

 \displaystyle
n \gt -\log(\frac{\alpha}{\lambda}) = \frac{-\log(0.1)}{0.05}=46.05
# 予想虚偽表示数が0の場合
tolerable_misstatement_rate = 0.05
expected_error_num = 0
confidence = 0.90
n = 100
while np.exp(-tolerable_misstatement_rate * n) < (1 - confidence):
    n = n - 1
print(n + 1)
AAG-SAM Table 4-5の再現

AAG-SAM Table 4-5では予想虚偽表示数ではなく予想虚偽表示率として算定されています。予想虚偽表示率 0.05で計算すると47件とでてきます。 しかし、AAG-SAM Table 4-5の同条件のサンプルサイズは69件です。

n = 200
tolerable_misstatement_rate = 0.05
expected_error_rate = 0.01
confidence = 0.90

while (poisson.cdf(k=expected_error_rate*n, mu=tolerable_misstatement_rate * n) <= (1 - confidence)) & (n>0):
  n = n - 1

print(n + 1)

これは、AAG-SAM Table 4-5では予想虚偽表示数を0件に丸めずに計算しているためです。ポアソン分布は離散分布なので、予想虚偽表示率で与えられても予想虚偽表示数は切り捨てられて整数に丸められて計算されます。一方で、AAG-SAM Table 4-5は連続のポアソン分布に拡張して計算しています。実際に詳細テストの虚偽表示数が整数でないことはないため、AAG-SAM Table 4-5は過度に保守的です。

AAG-SAM Table 4-5の計算方法はStewart, T.R. (2012)[2]に記載されており、どうやらVBAで計算されているようです。当時のVBA(Excel)の関数にポアソン分布の累積分布関数がなかったため、(連続な分布である)ガンマ分布に変換(拡張)することで、ガンマ分布の関数を用いて計算しているようです。(このせいでサンプルサイズが増えています。そう、Excelのせいで。)

ポアソン分布は事象の発生回数、ガンマ分布は事象がn回発生するまでの時間の分布です。同じ事象の観測を別の観点から見ているもので、定義から、ガンマ分布で n回の事象が時間 t以降に発生する確率(上側累積) = ポアソン分布で時間 t内に n回未満の事象が発生する確率(下側累積)がいえます。式で書くと次のようになります。

 \displaystyle
\int_{t}^{\infty} \frac{\lambda^k}{\Gamma(k)} s^{k-1} e^{-\lambda s} ds = \sum_{i=0}^{k-1} \frac{(\lambda t)^i}{i!} e^{-\lambda t}

この関係を用いて、敢えてガンマ分布に変換して計算すると、69件になること、さらに予想逸脱数を整数に丸めることで47件になることが確認できます。

tolerable_misstatement_rate = 0.05
expected_error_rate = 0.01
confidence = 0.90
n = 200

while (gamma.cdf(tolerable_misstatement_rate * n,a=1+expected_error_rate*n,scale=1) > (confidence)) & (n>0):
    n = n - 1

print(n + 1)

予想逸脱数を整数に丸める場合

while (gamma.cdf(tolerable_misstatement_rate * n,a=1+expected_error_rate*n,scale=1) > (confidence)) & (n>0):
    n = n - 1

AAG-SAM $6.20〜$6.31では、金額単位抽出のためのサンプルサイズ計算はAAG-SAM Table 4-5かAAG-SAM Appendix Table C-2を使用するように記載されていますが、これらは端数処理の違いのみです。AAG-SAM Appendix Table C-2では、ポアソン分布の  \mu を信頼度係数と呼び、小数点以下2位で切り捨てています。

$ 6.28の例では、許容逸脱率3%、予想逸脱率0.6%、信頼度95%の場合に、信頼度係数が4.62となり、サンプルサイズが155件になります。

# 6.28の再現
def floor_to_digits(value, digits):
    """小数点以下{digits}位で{value}を切り捨て"""
    multiplier = 10 ** digits
    return math.floor(value * multiplier) / multiplier

tolerable_misstatement_rate = 0.03
expected_error_rate = 0.006
confidence = 0.95
n = 200

while (gamma.cdf(floor_to_digits(tolerable_misstatement_rate * n,2),a=1+(expected_error_rate*n),scale=1) > (confidence)) & (n>0):
    n = n - 1
print(n + 1)

キーワード
金額単位抽出(Monetary Unit Sampling, MUS): 母集団の各金額単位に等しい抽出確率を与える方法。金額が大きい項目ほど抽出されやすくなります。確率比重抽出の一種です。
信頼度係数(reliability factor): 監査専門用語です。ポアソン分布の期待値パラメータ μのこと。AAG-SAMでは表を用いた計算のために端数処理されて使用されます。統計用語の信頼係数(confidence coefficient)とは別物です。

4.2. 金額単位抽出法の帰無仮説の前提の問題【修正予定】

(1) ポアソン分布の仮定
これについては、ある程度サンプルサイズが大きければポアソン分布は2項分布の良い近似になるため、そこまで影響はないです。

(2) 帳簿価額と虚偽表示率が独立
AAG-SAM $4.29では金額単位抽出では標本抽出時に変動性を考慮していると記載されていますが、棄却域の計算には反映されていません。金額と虚偽表示率は無関係だとは考えづらいです。なぜなら虚偽表示(重要な虚偽表示リスク)は金額によって発生確率が異なるからです。また、実際には金額単位抽出をしているため、金額重みづけで抽出していることになりますので、サンプルは金額が多いバイアスがあった上での虚偽表示率を観測していることになります。この前提も帰無仮説では反映されていません。
(3) 部分虚偽表示
部分虚偽表示が考慮されていません。もし、あるレコードが虚偽表示である場合、レコードの金額の100%が虚偽表示額になると仮定しています。実際には少しずれていただけのケースもあるので基本的には保守的になります。ただし、例えば、見積系の負債科目だと実際にはもっと大きかったというケースがあるので必ずしも保守的というわけではありません。

(4) 金額の不確実性の考慮について検討中です。
(AAG-SAMでは、元に期待値の積に分解してから上側信頼上限に持っていっていますが、本来初めから推定量の上側信頼上限を議論すべきです。この場合、信頼上限の積には分解できません。また、正規分布を仮定できないとブートストラップくらいしか方法がなくなってしまいます。)

4.3 【AAG-SAM】方法2: Classical Variables Sampling

詳細テストのサンプルサイズを計算する2つ目の方法は、Classical Variables Samplingと呼ばれています。
この方法では虚偽表示が多数生じるケースを想定しており、分散が既知の場合の正規分布の差の片側検定を行います。信頼度と検出力と母分散からサンプルサイズを決定します。前期までの情報等で母分散を決めないと使えず、あまり実用的ではありません。

観測した虚偽表示の合計  \bar{X} が正規分布  N(\mu,\frac{\sigma^2}{n}) に従うと仮定します。母分散  \sigma^2 は既知とします。帰無仮説では、  \mu=\mu_{0} を仮定し、合計  \bar{X} が正規分布  N(\mu_{0},\frac{\sigma^2}{n}) に従うとします。有意水準  \alpha で、観測した虚偽表示の合計  \bar{X} が  C_{\alpha} 以上であれば棄却するとします。  C_{\alpha} は臨界値です。 すなわち、

 \displaystyle
C\_{\alpha} = \mu_{0} - z_{\alpha}\frac{\sigma}{\sqrt{n}}

一方で、  C_{\alpha} で棄却する場合の検出力が  1-\beta である必要があります。検出力は対立仮説の分布を前提に計算します。

 \displaystyle
C\_{\alpha} = \mu + z_{\beta}\frac{\sigma}{\sqrt{n}}

上記2式から nについて解くと

 \displaystyle
n = \\{\frac{\sigma}{T}(z_{\alpha}+z_{\beta}) \\}^2

ここで  A=\frac{z_{\alpha}}{z_{\alpha}+z_{\beta}}T とおいて

 \displaystyle
n = \\{\frac{z_{\alpha}\sigma}{T}(\frac{A}{T})^{-1} \\}^2

AAG-SAM Table D-1では  \frac{A}{T} を小数点3位以降を切り捨てにした値が与えられ、これを用いて計算することになっています。
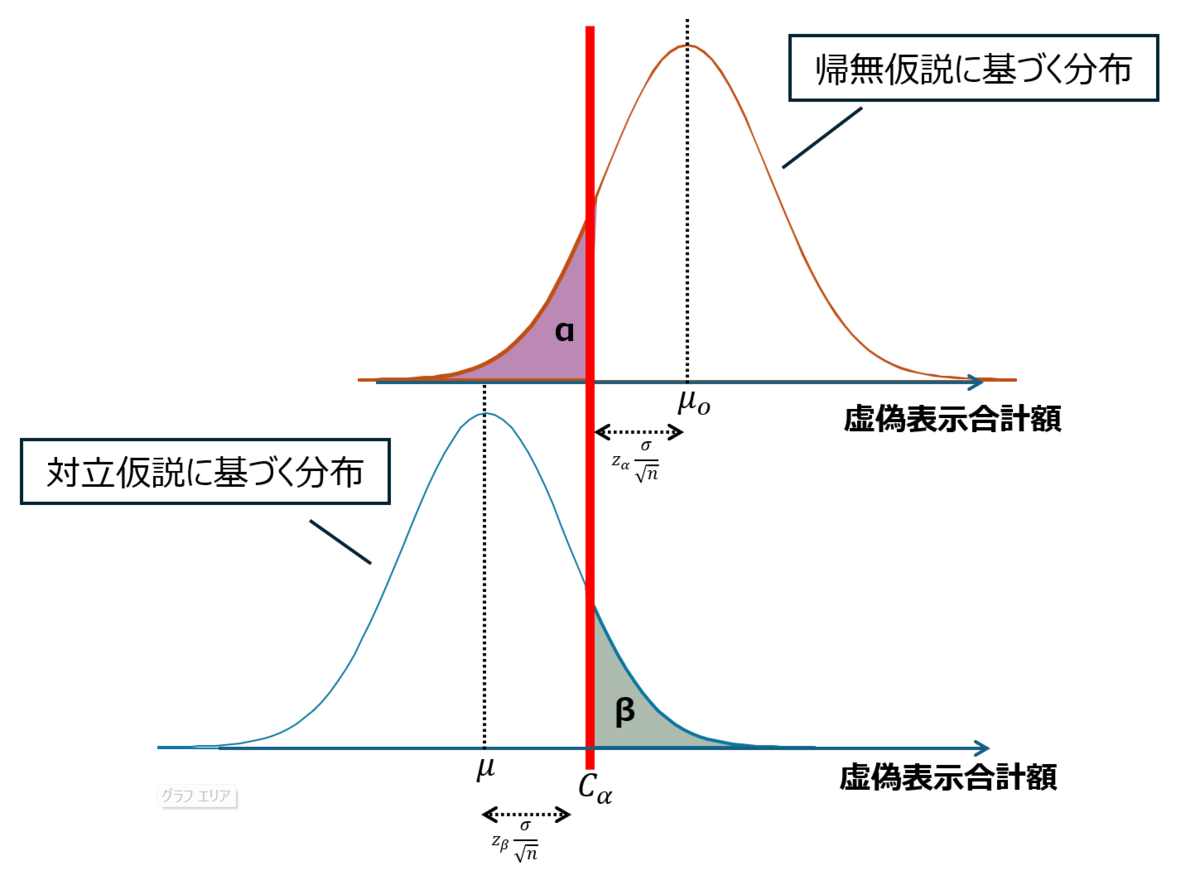
Classical Variables Samplingのイメージ

4.4 Classical Variables Samplingの前提の問題

(1) 母分散が既知というのは厳しいです。母分散がわからない場合、サンプルから推定することもできますが、虚偽表示がたくさんないと推定が難しいです。
(2) 虚偽表示合計が正規分布に従うことを仮定しています。合計値なので、中心極限定理により、n -> infで正規分布に分布収束するのですが、中心極限定理の収束速度は  \sqrt{n} のオーダーでかつ、標本金額の分布形状に影響され、歪みが大きいほど収束は遅くなります。
経済分野の金額の分布は(パレートの法則と言われるように)大抵の場合は裾が長い分布になりますので歪みが大きいです。十分にnが大きくないのに正規分布を仮定してしまうと、乖離してしまう可能性があります。さらに、classical variables Sampllingのサンプルサイズは検出力を用いて計算されており、予想虚偽表示額でぎりぎり棄却できるように設計している他の方法とは方針が大きく異なります。

4.5 【AAG-SAM】監査リスクモデル

ところで実証手続(詳細テスト)の範囲は内部統制の評価に影響を受けます。実は95%としていた信頼度は内部統制評価の結果によって決まっていることになっています。それを表現しているのが次の監査リスクモデルです。

重要な虚偽表示リスクに実証手続の範囲は依存します。 監査リスクを一連の監査の結果虚偽表示が存在する確率として、以下のようにエラー有無や不備の有無を定義します。
 x = {1: エラーがある場合, 0: エラーがない場合}
 y_{ic} = {1: 統制活動で不備とする, 0: 不備としない}
 y_{aud} = {1: 重要な虚偽表示があると推定, 0: 重要な虚偽表示がないと推定}

エラーがあり、かつ、統制の結果エラーがないと判断し、監査人が重要な虚偽表示がないと判断する確率  Pr( y_aud = 0, y_ic = 0, x=1) を分解すると

 \displaystyle
AR(x) = Pr( y_{aud} = 0, y_{ic} = 0, x=1)\\
 = Pr( y_{aud} = 0 | y_{ic} = 0, x=1) \ Pr(y_{ic} = 0 | x=1)\ Pr(x=1)

となります。 左から発見リスク、統制リスク、固有リスクと呼ばれています。 また、

 \displaystyle
Pr( y_{aud} = 0, y_{ic} = 0, x=1) \\
= Pr( y_{aud} = 0 | y_{ic} = 0, x=1)\ Pr(y_{ic} = 0, x=1)

のように、統制リスクと固有リスクをまとめて重要な虚偽表示リスクと書くこともできます。 また、発見リスク部分を詳細テストとその他の手続(実証手続における分析的手続)に分けている場合もあります。

監査リスクモデルの使い方ですが、例えば、アサーションレベルの監査リスクが5%、内部統制を評価して重要な虚偽表示リスクが60%の場合

 \displaystyle
Pr( y_{aud} = 0 | y_{ic} = 0, x=1) \times 60\% = 5\%

となります。つまり、要求される発見リスクは5%/60% = 8.3%となります。 ここで、統制活動は対象の業務プロセスのすべてに対して実施されますが、監査人の詳細テストはサンプリングによって実施されます。監査人の手続が適切でサンプルの中の誤りを見落とす確率が0%と仮定すると、発見リスクはサンプリングリスク、すなわち1-要求信頼度となります。

ところで、上の例で60%と仮定した重要な虚偽表示リスクについてですが、AAG-SAMでは、重要な虚偽表示リスクは10%, 30%, 50%, 100%と非常に広い範囲を想定しています。 重要な虚偽表示リスクは内部統制で評価した逸脱率から決まると思っていたのですが、この部分の関係は記載されていませんでした。許容逸脱率ベースだとすると10%程度なので、スケールが合いません。 AAG-SAMには「監査リスクモデルは各リスクの関係を理解するためのもので、監査リスクモデルを使って直接リスクを計算する必要はない」と書かれていますが、この部分の関係性があってこそ内部統制監査と財務諸表監査の一体監査が設計できるので、もやもやしています。

4.6 サンプリングではなくAI等による全件調査を採用する場合

すでに監査の現場ではAIによる自動監査を用いて、全件調査を採用しているケースがあると思います。 サンプリングの場合、選んだサンプルに対しては100%確実で適切な調査がされる前提ですが、一方で、AI等による全件調査の場合には、すべてのサンプルに対して一定の水準の調査がされる前提(を受け入れざるを得ない状況)になります。統計的サンプリングでは発見リスク=サンプリングリスクとしていましたが、発見リスクを全件調査で見落とすリスクとして扱う必要がでてきます。

AIで全件調査をする場合は、サンプリングの場合と異なり、推定による虚偽表示の性能を信頼度等であらかじめ設計することができません。事後的にインプットデータを見てAIの予測精度を評価する必要があります。

4.7 【AAG-SAM】虚偽表示の上限(上限虚偽表示額)の推定

内部統制の運用評価手続とは異なり、詳細テストでは虚偽表示の上限は帰無仮説が成り立つ前提で計算します。帰無仮説が棄却されているので、推定した虚偽表示額がこれを上回ることはないというロジックです。(ですので、詳細テストの計画時に許容虚偽表示額が適切に設定されていればただの出来レースな気がします。)

帰無仮説は虚偽表示件数についてポアソン分布  poisson(\mu) を仮定していました。この  \mu はサンプルサイズ設計の際に計算しています。 例えば、信頼度95%、許容虚偽表示率3%、予想虚偽表示率0.6%の時の  \mu は6.3でした。これは帰無仮説における許容虚偽表示数を連続値にしたものです。
ここで、この連続値にした許容虚偽表示数に平均金額(金額単位抽出のサンプリング間隔)を乗じたものが、虚偽表示の上限となります。

ちなみに、詳細テストで棄却できない場合には帰無仮説の成立を積極的に主張して推定することはできません。そのためか、帰無仮説を棄却できないときに帰無仮説で計算した虚偽表示の上限にはほとんど意味がなく、AAG-SAMに該当する記載はありませんでした。

キーワード
上限虚偽表示額(upper limit on the misstatement):帰無仮説の棄却上限で計算した虚偽表示額の上限の推定値

4.8 【AAG-SAM】部分虚偽表示(Tainting)がある場合

虚偽表示が帳簿価額の一部である場合、Taintingが発生していると表現し、帳簿価額に対する虚偽表示額の割合をTainting率と呼びます。4.2や4.7ではTaintingは常に100%(もしあるレコードが虚偽表示であるなら、その帳簿価額がそのまま虚偽表示額。つまり全額計上を認めないケース)を仮定していました。Taintingを常に100%を仮定することは保守的にサンプルサイズや推定上限虚偽表示額を算定できます。このうち推定上限虚偽表示額については過度に保守的であることが監査の効率性を大きく損ねるため、Taintingを考慮した算定方法が提案されています。Taintingを考慮する場合は、Stringer boundと呼ばれる方法で、実際のTainting割合ベースで計算するものの、その不確実性を上限に反映させるアプローチです。100%Taintingで計算するよりは推定額が小さくなります。 4.2で説明した通り、推定したい虚偽表示額は次のように表されます。

 \displaystyle
\Sigma_{i \in B}M_{i}\tau_{i} = N E[M_{i}]E[\tau_{i}]

この  \tau が0〜1の値をとる場合を考えます。 ここでは予想逸脱数だけ虚偽表示が発生していると仮定します。(つまりサンプルサイズが適切に設計されていれば帰無仮説は棄却できている前提です。) サンプルの虚偽表示金額は

 \displaystyle
\bar{M} E[\tau_{i}] = \bar{M}\Sigma_{i=1}^k 1_{i} \tau_{i}

とかけます。この値の90%推定上限を求めたいのですが、  \Sigma_{j=1}^k 1_{j} の推定上限は k件の許容逸脱率が発生する場合の帰無仮説のポアソン分布の  \mu です。  \mu_{k} と書きます。 虚偽表示がもし、j-1件であれば  \mu_{j-1} であり、虚偽表示が j-1件から j件に増えたときの増分は  \mu_{j}-\mu_{j-1} となるので、推定上限  \mu_{k} は  \Sigma_{j=1}^k \mu_{j}-\mu_{j-1} と分割できます。その結果、推定上限は  \Sigma_{j=1}^k (\mu_{j}-\mu_{j-1})\tau_{j} となりますが、  \mu_{j}-\mu_{j-1} と  \tau_{j} の対応関係は不明です。要素積の最大値は再配列不等式(rearrangement inequality)により  \tau_{0}\geq\tau_{1}\geq \dots \geq\tau_{k} と再配列した場合となります。 その結果、  \Sigma_{j=1}^k (\mu_{j}-\mu_{j-1})\tau_{j} (ただし  \tau_{0}\geq\tau_{1}\geq \dots \geq\tau_{k} )が推定上限と計算できます。 具体的な計算例についてはAAG-SAM $6.44以降に記載があります。

で、この計算は適切なのかというと、あまり自信がないです。件数ベースの推定上限に  \tau をかけあわせているときの、組み合わせを再配列不等式で最大にしているだけなので、  \tau 自信の不確実性を考慮していないのではないかと考えています。違っていたらごめんなさい。実務的にはTainting100%を仮定してやってしまうのが無難だと思います。

4.9 ベイズモデルによる虚偽表示額の上限推定

AAG-SAMでは帰無仮説ベースの推定上限の計算しか記載されておらず、帰無仮説が棄却できなかった時の金額的な重要性の評価が行えません。 というわけで、詳細テストを行なった手元のサンプルの観測から、虚偽表示を推定する方法を紹介します。 先ほどと同様に、

 \displaystyle
\Sigma\_{i \in B}M\_{i}\tau\_{i} = N E[M\_{i}]E[\tau\_{i}]

の  \tau が0〜1の値をとる場合を考えます。  \tau が1を超える拡張はとりあえず考えません。 ここでは  \tau を明示的にモデリングします。 虚偽表示が発生するケースは稀なので  \tau の観測のほとんどは0になります。このような場合はzero inflatedな分布でモデリングできます。例えば、階層ベータ分布は  \tau が0か1かの予測(ベルヌーイ分布)と0より大きい値をとる時の値の生成(ベータ分布)の2階層のモデルをつくることができます。 また、特徴量のデータが十分にある場合には0か1かの予測を2項分布GLM、0より大きい値をとる時の値をロジスティック回帰で別々に行うことも考えられます。

4.10 金額単位抽出を活かした虚偽表示額の推定

<2026/08/07>"金額単位"抽出を考慮してモデリングして議論できるため、こちらも訂正いたします。

金額単位抽出と言いながら、ここまで抽出ウェイトを利用した推定の話が出てきませんでした。 金額単位抽出により層化されて効果的になるみたいなことはAAG-SAMに記載がされていましたが、サンプルサイズ計算における帰無仮説の仮定に反映されているわけでもなく、単に金額のカバー率を高めるのみで統計的推測には加味されていないように思えます。むしろ選択バイアスが邪魔になっているのではとも思います。 せっかくなので、この選択バイアスを活かした虚偽表示の推定方法を紹介します。 金額単位抽出は金額に比例して抽出確率が上がるので、確率比重抽出(probability proportional sampling)とみなすことができます(ここまではAAG-SAMに記載されています)。母集団の虚偽表示額の推定は帳簿価額を補助変数にしたHansen-Hurwitz推定量を用いることで、分散の小さい推定を行えます。簡単にするために、抽出間隔の金額を超える帳簿価額は別で精査するために除外していると仮定します。 抽出確率  p_{i} は帳簿価額に比例した  p_i=\frac{x_{i}}{\Sigma_{j} x_{j}} となります。 抽出ウェイト  w_{i}=\frac{1}{np_{i}}=\frac{\Sigma_{j} x_{j}}{nx_{i}} を用いて、  \Sigma w_{i}y_{i} として計算できます。

ここで、あれ、HH推定量の信頼区間ってどうするのだろうと思って調べてみたところ、ブートストラップ法を使ってサンプルからのシミュレーションで計算しているようでした。サンプルから虚偽表示が大量に見つかるケースは想定しづらいので、計算はちょっと難しいのかなと思います(というより、力尽きました。また活力が湧いたら勉強して調べてみます。)。

私の考える最強の統計的サンプリング

ベイズモデルは事前知識の導入や監査リスクモデルにおけるリスクの分解や条件付けによる分離と相性がよく、自然に監査リスク全体をモデリングできると考えています。さらに、ベイズ推定に必要なサンプルが集まるまでの間に明らかに逸脱率や虚偽表示リスクが小さい場合は棄却する多段階検定計画(逐次検定計画)を取り入れることができそうです。能動サンプリングのような現状のモデルの不確実性によってサンプリングするアプローチも盛り込みたいです。 一方で、ベイズモデリングでも金額に比例した抽出を行なっている場合には、HH推定量の分散が補助変数によって小さくなるのと同様に事後分布の裾が狭くなったりするとよいのですが、ベイズモデリングでは抽出の工夫を反映させることが難しいなと悩んでいます。

以上の要望に応える最強の統計的サンプリングをpythonで実装してください。とかやれば近い将来のAI先生がきっといい感じの手法をつくってくれることでしょう。

まとめ

統計的サンプリングは統計学の社会実装として大変美しく、実務の複雑さゆえに多くの問題があります。 この記事ではあくまで統計学的な見方で議論しましたが、さらに実務的な要請が加わります。 特に現場で活躍する監査担当者はルールや理論がそのまま当てはめることができない場合に多く遭遇していることでしょう。そのときルールや理論と現実にとれる方法の間を如何に器用に埋めれるかのセンスが問われます。 ここで紹介した背景や論点が現実の難しい問題解決のヒントになれば幸いです。 読んでくださりありがとうございました。

参考文献

監査における統計的サンプリング関連

[1] AAG-SAM: American Institute of Certified Public Accountants (AICPA) (2017), "Audit sampling, May 1, 2017; Audit Guide" (2017). Industry Guides (AAGs), Risk Alerts, and Checklists. 1372. https://egrove.olemiss.edu/aicpa_indev/1372
本記事で解説の対象としているガイドです。

[2] Stewart, T.R. (2012). "Technical Notes on the AICPA Audit Guide Audit Sampling".
https://www.studocu.com/row/document/the-american-university-in-cairo/banking/sampling-guide-technical-notes/112706217
AAG-SAMのTableの数値の算定方法が書いてあります。

[3] Roberts, Donald M., (1978). "Statistical auditing". Guides, Handbooks and Manuals. 1576. https://egrove.olemiss.edu/aicpa_guides/1576
AAG-SAMの元になったものと思われます。

[4] 企業会計審議会(2023),「財務報告に係る内部統制の評価及び監査の基準並びに財務報告に係る内部統制の評価及び監査に関する実施基準(令和5年4月7日時点)」 https://www.fsa.go.jp/singi/singi_kigyou/top.html
(2)①ロ.a.に25件が例示されています。

[5] Durney, Michael Thomas and Elder, Randy and Glover, Steven M., (2013), "Error Rates, Error Projection, and Consideration of Sampling Risk: Audit Sampling Data from the Field". Available at SSRN: https://ssrn.com/abstract=2245866 or http://dx.doi.org/10.2139/ssrn.2245866

[6] 加藤 真大, 中川 慧(2025) 財務諸表監査のための逐次検定:試査手順の統計学的な定式化と理論保証
https://www.jstage.jst.go.jp/article/jsaisigtwo/2025/FIN-035/2025_117/_article/-char/ja/
監査サンプリングにおける逐次検定を扱っています。

[7] Koen Derks (2025) Statistical Audit Sampling with R.
https://koenderks.github.io/sasr/
ベイズを用いた統計的サンプリングを大きく扱っています。頻度論を使っている場合はAAG-SAMに概ね準拠しています。ベイズモデルや階層化のサンプルサイズの決め方はかなり攻めてます。

[8] 富田 竜一, 西山 都, 石原 佳和 (2007), 『Q&A監査のための統計的サンプリング入門』, 金融財政事情研究会.
監査における統計的サンプリングについて背景から実務的なポイントまでわかりやすく説明されています。計算部分についてはAAG-SAMに準拠しています。

[9] 増田 幸一(2018)『監査における統計的サンプリング法 米国公認会計士協会Audit Guide準拠』, 米国公認会計士協会.
AAG-SAM[1]と"Technical Notes on the AICPA Audit Guide Audit Sampling"[2]のうち計算部分を抜粋して翻訳したものに、導出が追加されています。導出が少々遠回りなところがありますが計算方法を解読するためには大変参考になります。

[10] 稲垣 大輔, 小澤 圭都 著, 野呂 祐介, 蜂谷 悠希 (2023)『Pythonではじめる会計データサイエンス』, 中央経済社.
https://www.biz-book.jp/isbn/978-4-502-43811-0
3章で監査サンプリングを扱っています。このブログでは扱っていない取引レコードから実際にサンプリングを行うPythonコードの解説もあります。

統計関連

[10] 竹村 彰通(2020),『現代数理統計学』, 学術図書出版社.
https://www.gakujutsu.co.jp/product/978-4-7806-0860-1/
信頼できる本です。基本的な統計で困ったらこれを確認しています。

[11] 星野 匡郎(2025),『統計的仮説検定の方法論』, 日本評論社.
https://www.nippyo.co.jp/shop/book/9561.html
仮説検定について詳しく信頼できる本です。現代的な問題設定を扱ってくれていて大変ためになります。

[12] 永田 靖(2003),『サンプルサイズの決め方』, 朝倉書店.
https://www.asakura.co.jp/detail.php?book_code=12665&srsltid=AfmBOoqt214Eg88VfwTaYCU_7jaTjVEcSSAP0MawyyDhVH5Mvp3T3TO0
主にパラメトリックな検定についてのサンプルサイズの計算方法が詳しく解説されています。監査サンプリングでは予測逸脱数ぎりぎりで棄却できるようにサンプルサイズを決めているため、こちらの本の内容とは乖離があります。ただし、本記事4.3で扱ったClassical Variables Samplingは一般的な統計学の方法に基づいており、本記事を解読するよりも、こちらの3章を読むことをお勧めいたします。

[13]土屋 隆裕 『標本調査法』, 朝倉書店.
https://www.asakura.co.jp/detail.php?book_code=12791&srsltid=AfmBOorjvWvefXk1hTb7TXFfJ88C2_cvtc3bv2lIZDBAdB9b7hxf2r2I
本記事4.10で紹介したHH推定量(やHT推定量)について、さまざまなサンプリング方法から詳しく解説されています。
99から始める有価証券報告書XBRLデータ分析

はじめに

この記事は会計系 Advent Calendar 2024 18日目の記事として投稿させていただいています。

「Pythonで会計データの分析をやってみたいけど簡単に使えるデータがない」そんなニーズにお応えして、オープンデータの有価証券報告書の提出データを分析してみます。 しかし、このデータはXBRLと呼ばれる構造化ドキュメントです。XBRLは、その構造が大変複雑で扱いづらい点と、データが散らばっている点で分析が困難です。

そこで、XBRLの複雑な部分をまるっと隠して必要な情報だけ抽出するラッパーをつくりました。 とりあえず、pythonライブラリのpandasで扱えるテーブルにしてしまえば、一般的なテーブルデータと同様に扱えるでしょう。データモデリングでいうところの大福帳(One Big Table)をつくってしまおうという訳です。 「データサイエンスの9割は前処理」と言われますが、XBRLについては99%が前処理です。皆様は混沌としたXBRLの前処理から解放されて、会計データの深い分析にリソースを充てることができます。

ちなみに99の内訳ですが、EDINET APIからのダウンロードが5、XBRLインスタンスのパースが85(Arreleにおまかせ)、スキーマファイルとリンクベースファイルからの情報抽出が9くらいです。私の貢献は10くらいでしょう笑

ラッパーのソースコードはGitHubで公開しています。

github.com

また、このブログで実演する分析のノートブックはgoogle colaboratoryでも提供しています。

colab.research.google.com

google colaboratoryは環境構築不要でブラウザさえあれば簡単にpython等を用いた分析を試すことができます。しかし、勝手にライブラリのバージョンが上がっていく困り者で、しばらくはメンテナンスしようと思います。 最終動作確認: 2024/12/19

このブログ本文ではコードを抜粋して説明するので、完全なコードはGitHubリポジトリのノートブックまたはGoogle colaboratoryのものを参照してください。

0. 準備

0.1. 環境構築

具体的な環境構築方法は時代によって大きく変わるため、省かせていただきますが、筆者の環境作成手順を[注1]に記載しております。環境を構築できる方は[注1]を参考に、仮想環境を作成してください。

環境構築をしたことがない方はgoogle colaboratoryでやりましょう。

0.2. EDINET APIキーの発行

EDINET APIの仕様書を参考にAPIキーを発行し、どこかにメモしておいてください。仕様書は以下の「EDINET API関連資料」の「EDINET API仕様書(Version 2)」からダウンロードできます。

disclosure2dl.edinet-fsa.go.jp

0.3. Groq APIキーの発行

※X(旧twitter)のGrokではありません。Groqは高速で生成AIの推論APIを提供してくれるサービスで、2024/12/19時点でフリープランがあります。Googleアカウント等でアカウントを作成し、APIキーを発行してください。

console.groq.com

日本語でAPIキー発行までの手順が記載されているブログがあり参考になると思います。

zenn.dev

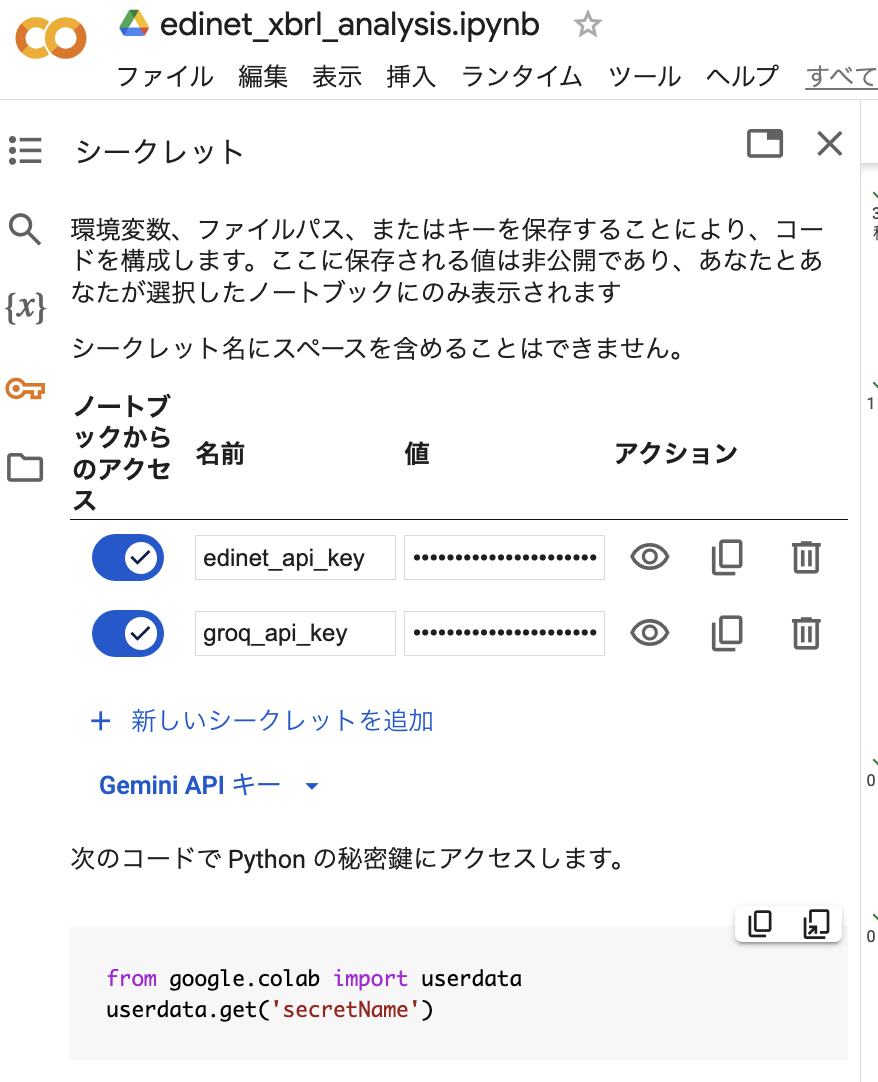
0.4. APIキーの設定

以下のコードでAPIキーを変数に代入できます。

input("Please input your API key: ")

Google Colaboratoryでは以下の画像のようにシークレットキーに設定してください。

Google colaboratoryでのシークレットキーの設定

1. EDINET APIから書類一覧を取得し、分析対象を絞る

まずはEDINETからデータをダウンロードする必要がありますが、全てのデータをダウンロードするには1週間くらいかかるため、ここでは分析対象を絞ります。 まずは、EDINET APIでダウンロード可能な書類一覧を取得します。 ダウンロード可能な書類一覧を取得する範囲は提出日でしか絞れないので、まずはざっくり有報の提出が集中する2024/6/15〜2024/6/30の期間で取得します。

# 書類一覧の取得
res_results:EdinetResponseList = request_term(api_key=your_api_key, start_date_str='2024-06-15', end_date_str='2024-06-30')

json Lines形式のレスポンスを格納するクラスを作っているため、これにセットしてjson Lines形式で保存します。 tse_sector_urlは業種情報が入っている東証上場銘柄一覧のダウンロードリンクです。毎月更新されるため、tse_sector_urlへ代入するリンクは適宜書き換えてください。ちなみに、EDINETでもこちらで業種情報を提供しています。

edinet_response_metadata_obj = edinet_response_metadata(
    tse_sector_url = "https://www.jpx.co.jp/markets/statistics-equities/misc/tvdivq0000001vg2-att/data_j.xls",
    tmp_path_str = str(DATA_PATH)
)
edinet_response_metadata_obj.set_data(res_results)
filename = str(DATA_PATH / "data.jsonl")
edinet_response_metadata_obj.save(filename)

インスタンス化の際にfilenameを指定することで保存したjson Linesを読み込めます。

edinet_response_metadata_obj = edinet_response_metadata(
    filename = str(DATA_PATH / "data.jsonl"),
    tse_sector_url = "https://www.jpx.co.jp/markets/statistics-equities/misc/tvdivq0000001vg2-att/data_j.xls",
    tmp_path_str = str(DATA_PATH)
    )

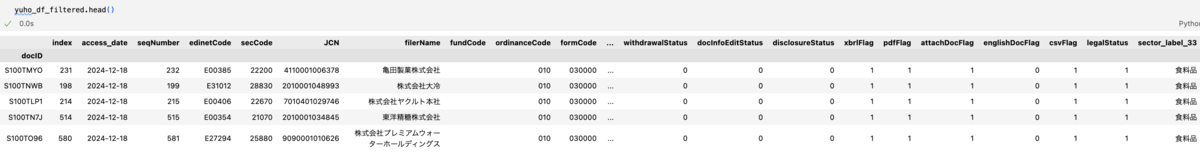
edinet_response_metadataインスタンスの.get_yuho_df()メソッドで提出書類一覧の中から有価証券報告書に絞ったリストをデータフレームで出力します(有価証券報告書は書類種別コード='120'かつ政令コード='010'かつ様式コード='030000'で抽出しています。)

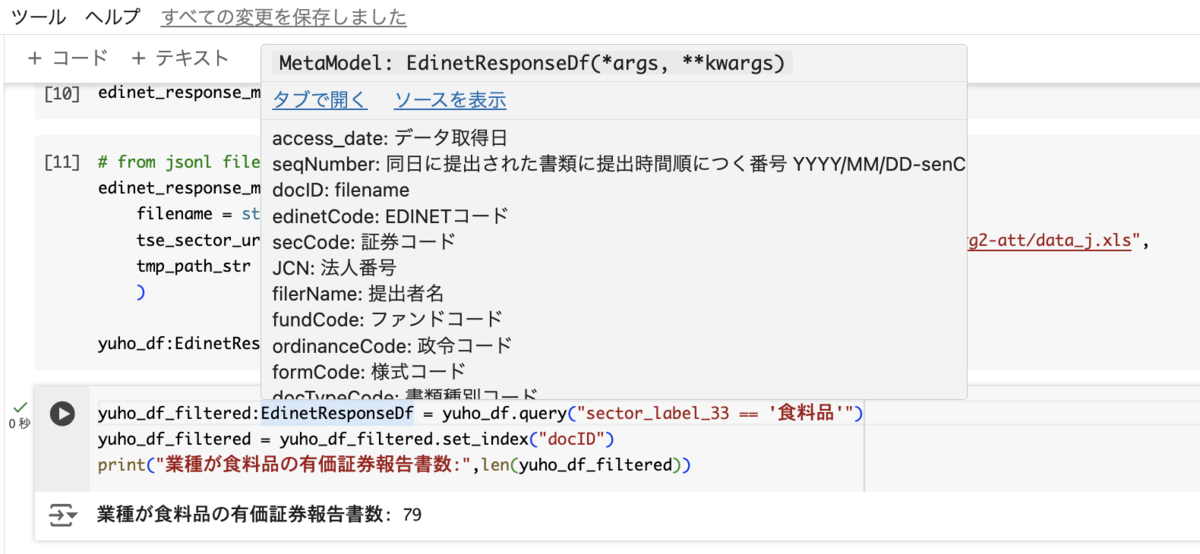
全部分析すると時間がかかるため、ここでは業種を絞ります。業種情報はカラム「sector_label_33」に入っています。 リスポンスのうち提出書類が有価証券報告書であるものをpandas.DataFrameで出力し、業種を食料品に絞ります。

yuho_df = edinet_response_metadata_obj.get_yuho_df()
yuho_df_filtered:EdinetResponseDf = yuho_df.query("sector_label_33 == '食料品'")
print("業種が食料品の有価証券報告書数:",len(yuho_df_filtered))

79個あると少し時間がかかってしまうため以降では上から30個を分析します。 また、ここで「docID」カラムをインデックスに指定しておきます。「docID」カラムはダウンロードした提出書類のファイル名にもなっており、提出された有価証券報告書を特定するキーとして利用します。

yuho_df_filtered = yuho_df_filtered.set_index("docID").head(30)
# 5行表示
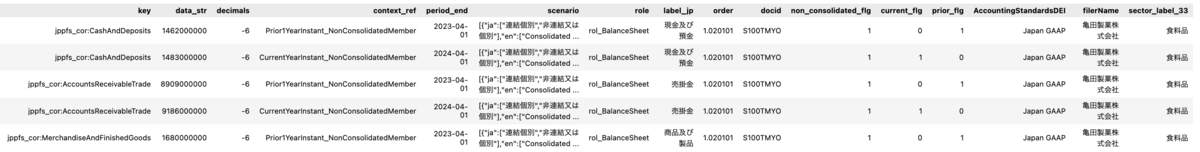
yuho_df_filtered.head()

書類一覧APIのレスポンスデータ

ちなみに、Google colaboratoryや(静的解析の拡張機能が入った)VSCodeでは画像のようにpythonの変数の型ヒントとドキュメンテーションをマウスオーバーで表示できるので利用する際に参考にしてください。

型ヒントとドキュメンテーションの表示

2. EDINET APIからの有価証券報告書のダウンロード

ダウンロードします。業種を絞った提出書類一覧からdocidを渡せばダウンロードできます。 ダウンロード先はout_filenameで指定します。

res_results = []
for docid in tqdm(yuho_df_filtered.index):
    out_filename = str(DATA_PATH / "raw/xbrl_doc" / (docid + ".zip"))
    res_results.append(request_doc(api_key=your_api_key, docid=docid, out_filename_str=out_filename))
    sleep(0.5)
print("取得失敗数: ",len([res for res in res_results if res.status == 'failure']))

3. 有報XBRLデータの大福帳(One Big Table)の作成

2024年の共通タクソノミ(勘定科目マスタのようなもの)をダウンロードします。2023年の有価証券報告書を分析する場合は2023年のものが必要です。1分40秒くらいかかります。

account_list_common_obj_2024 = account_list_common(
    data_path=DATA_PATH,
    account_list_year="2024"
)

有価証券報告書の中の財務諸表等(貸借対照表や損益計算書、注記など)は「role」カラム(目次項目の拡張リンクロール)で分けられています。全部取得すると時間がかかるため、必要なものに絞って処理します。 ロール名を検索するキーワードを指定します。 BS: 貸借対照表、PL: 損益計算書、CF: キャッシュフロー計算書、SS: 株主資本等変動計算書、notes: 注記、report: 前段(事業の状況など) report以外には連結と個別の両方があります。

# 拡張リンクロール検索キーワード
fs_dict = {
    'BS':["_BalanceSheet","_ConsolidatedBalanceSheet"],
    'PL':["_StatementOfIncome","_ConsolidatedStatementOfIncome"],
    'CF':["_StatementOfCashFlows","_ConsolidatedStatementOfCashFlows"],
    'SS':["_StatementOfChangesInEquity","_ConsolidatedStatementOfChangesInEquity"],
    'notes':["_Notes","_ConsolidatedNotes"],
    'report':["_CabinetOfficeOrdinanceOnDisclosure"]
}

指定したキーワードを含むロールの財務諸表等データをpandas.DataFrameで取得します。1書類あたり30秒弱かかってしまいます(高速化を検討していますが、筆者の手元にある10年分の有報データがだいたい45000書類くらいですが、20コア程度で並列化をすることで1日くらいで完了してしまい高速化のモチベが湧きません)。

# XBRLから必要なロールの財務情報を取得
fs_tbl_df_list = []
for docid in tqdm(yuho_df_filtered.index):
    fs_tbl_df:FsDataDf = get_fs_tbl(
        account_list_common_obj=account_list_common_obj_2024,
        docid=docid,
        zip_file_str=str(DATA_PATH / "raw/xbrl_doc" / (docid + ".zip")),
        temp_path_str=str(DATA_PATH / "raw/xbrl_doc_ext" / docid), 
        role_keyward_list=fs_dict['BS']+fs_dict['PL']+fs_dict['report'], # ロールを指定
    )
    fs_tbl_df = fs_tbl_df.assign(
        filerName=yuho_df_filtered.loc[docid,'filerName'],
        sector_label_33=yuho_df_filtered.loc[docid,'sector_label_33']
    )
    fs_tbl_df_list.append(fs_tbl_df)
fs_tbl_df_all:FsBigTableDf = FsBigTableDf(pd.concat(fs_tbl_df_list))

有報XBRLの大福帳データの主なカラム

これでXBRLのデータをまとめることができました。以降はいくつかの探索的データ分析の例をご紹介するだけなので、自分で分析したい方は、ブログを閉じて分析を楽しんでください。

4. 有価証券報告書前段部分のテキスト分析

それでは、ここから分析に入っていきます。

データ分析は大きく仮説検証と仮説探索の2つがあります。前者は既に分析者に仮説があって、それをデータで検証します。A/Bテストや因果効果の測定等がこれに該当します。後者はデータをあれこれ見ながら仮説を探索します。今回はデータから仮説を見つけたいので後者の分析を進めていきます。(したがって、見つけてきた仮説については、独立したデータで再現性を確認する必要があります。)

まずは、有価証券報告書前段の事業等のリスクを分析してみます。どんなことが書かれているか大雑把に把握することが目的です。テキストを全部生成AIに丸投げして要約でもよいのですが、文章量が多いため、ここではLDA(latent dirichlet allocation)という古典的なモデルを使います。

まずは、有価証券報告書の前段部分を抽出します。roleは3.に記載されている拡張リンクロール検索キーワードを参考にしてください(そのうち日本語のラベルもつけます。)。

text_df = fs_tbl_df_all.query("role.str.contains('CabinetOfficeOrdinanceOnDisclosure')")

4.1. 事業等のリスクの分析

gensimのインストールでハマってしまった方は4.1を飛ばしてください。 日本語のフォント設定がないと図の文字が「口」になってしまうためmatplotlib_fontjaというライブラリからフォントを取得します。利用にあたってはIPAフォントライセンスv1.0に同意してください。

# wordcloud用に日本語のフォントを取得
font_dir_path = get_font_path()
font_dirs = [font_dir_path]
font_files = font_manager.findSystemFonts(fontpaths=font_dirs)

有報の前段部分から事業等のリスクを抽出します。

business_risk_df = text_df.query("key == 'jpcrp_cor:BusinessRisksTextBlock'")

テキストの前処理をします。XBRLデータのテキストはhtml形式になっているため、テキスト部分以外を削除し、余計な改行や特殊な記号を削除します。形式的な処理なのでedinet_xbrl_prep.preproc_nlp()に処理を入れ込んでしまっています。他の処理をしたい方は自作しましょう。

次に、単語単位での分析をするため、janomeライブラリを用いてトークン化します。トークン化に際して、名詞と形容詞以外は削除しています。インストールの容易さだけでjanomeを選んでいるので、しっかり分析する場合には他のライブラリも検討しましょう。

janome_tokenizer = Tokenizer() # janomeのトークナイザー

def tokenize_janome(text:str)->str:
    """単語分割をして、名詞と形容詞のみを取り出す"""
    return [token.surface for token in janome_tokenizer.tokenize(text) if token.part_of_speech.split(',')[0] in ['名詞','形容詞']]

business_risk_df['text_processed'] = business_risk_df.data_str.apply(preproc_nlp,drop_htmp=True,drop_number=True,reduce_return=True)
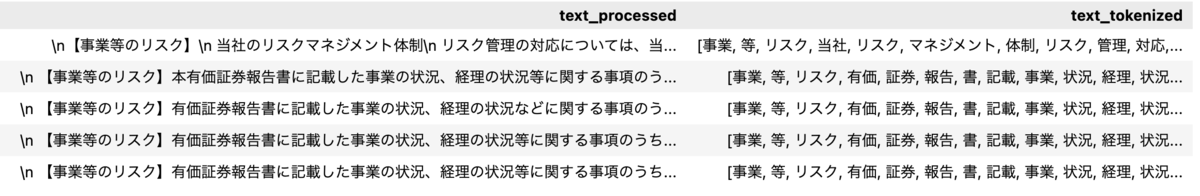
business_risk_df['text_tokenized'] = business_risk_df.text_processed.apply(tokenize_janome)

business_risk_df.head()['text_tokenized']

単語分割の様子

このように単語で分割されています。

分割した単語から辞書を作成します。作成に際しては、複数書類にわたって出現しているが、出現率が70%未満である単語に絞ります。1書類にしか登場しない単語は固有名詞などが多く、また、多くの書類で登場する単語は特徴のない単語ですので、このようなノイズになる単語は削除しておきます。 出現頻度が少ない特徴的な単語を際立たせるためTF-IDFを計算し、それに対してLDAモデルを訓練します。

dictionary = Dictionary(business_risk_df['text_tokenized'].to_list())
# 1書類にしか出現しない単語、70%以上の書類に出現する単語を削除
dictionary.filter_extremes(no_below=2, no_above=0.7,keep_n=400000)
# トークンIDに変換
business_risk_df = business_risk_df.assign(text_tokenized_id=business_risk_df.text_tokenized.apply(dictionary.doc2bow))

tf_idf = True
bow_corpus = business_risk_df.text_tokenized_id.to_list()
# TF-IDFを計算
if tf_idf:
    tfidf = TfidfModel(bow_corpus)
    corpus_tfidf = tfidf[bow_corpus]
    corpus = corpus_tfidf
else:
    corpus = bow_corpus

NUM_TOPICS = 10 # トピック数
# LDAモデルの学習
lda=LdaModel(corpus=corpus, num_topics=NUM_TOPICS, id2word=dictionary,alpha='auto',random_state=0)

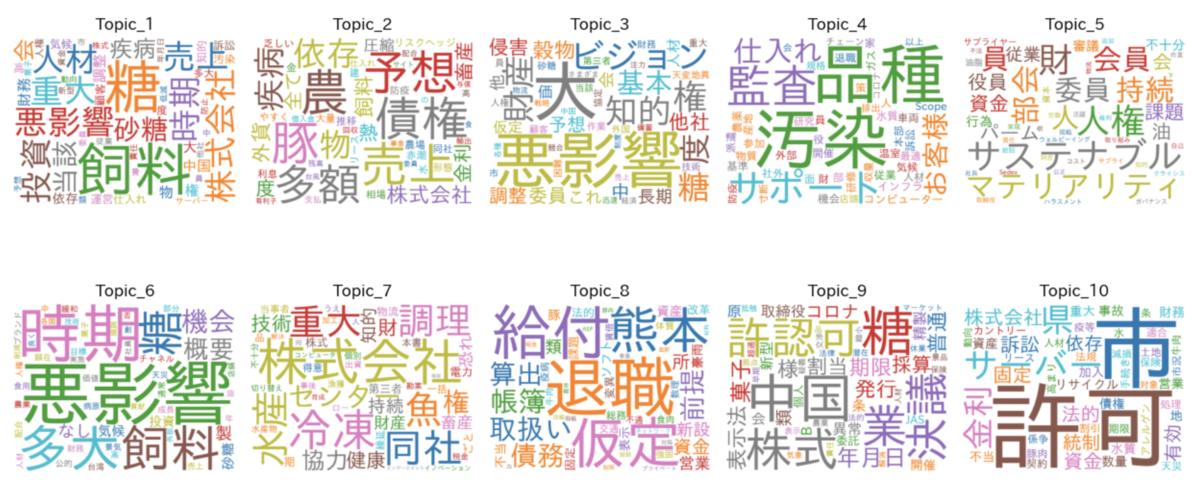
LDAトピックの成分である単語をワードクラウドで可視化します。文字サイズはトピックにおける単語の重要度です。

事業等のリスクのトピック

4.2. 事業内容の抽出

1.で取得したように東証やEDINETが業種情報を提供していますが、企業によっては該当する業種区分がなかったり、複数の事業を行ってることもあるため、不十分な場合があります。 そこで、有価証券報告書前段の事業の内容に記載されたテキストからその会社の事業内容を生成AIで抽出します。生成AIはGroqを使用しますので、「0.3. Groq APIキーの発行」が完了している必要があります。

前段部分から事業の内容を抽出します。

business_desc_df = text_df.query("key == 'jpcrp_cor:DescriptionOfBusinessTextBlock'")
business_desc_df['text_processed'] = business_desc_df.data_str.apply(preproc_nlp,drop_htmp=True,drop_number=False,reduce_return=True)

生成AIのインプットにするプロンプトを作成し、例を出力します。 生成AIプロンプトは洗練されたものではないですが、いくつかポイントがあります。
- markdown形式で記載
- 例を記載
- 抽出項目に「事業内容」と分けて「具体的な説明」をつくっておくことで、「事業内容」に簡潔なテキストが入るように誘導する。

# プロンプトの作成
example_text="""
##### 文章
3 【事業の内容】当社の主たる事業は物流業であります
その事業は....(このブログ上では省略します)

##### 回答
``json
{"事業内容":"貨物運送事業","具体的な説明":"食料品、日用品雑貨等の消費関連貨物の輸送に加え、第一・第二種利用運送事業も実施。"}
{"事業内容":"倉庫事業","具体的な説明":"営業倉庫と物流センターの運営。集荷・保管・流通加工・配送・回収までの一貫したサービスを提供"}
...``
以上の指示に従って、提供された文章から、事業内容を抽出して整理してください。
"""

prompt_ext_business = Prompt(**{
    "instruction": """提供される文章はある会社の事業内容に関する文章の抜粋です。ここからわかる会社の主な事業内容を日本語で列挙してください。""",
    "example": example_text,
    "constraints_list": ["できるだけ文章中の記載をそのまま引用してください。","固有名詞は伏せてください。","具体的な説明がある場合は、それも記載してください。ない場合は「なし」としてください。"],
    "output_format": """#### 回答形式\n\nフォーマットは個別のjson形式で回答してください。\n\n{"事業内容":"(事業内容1)","具体的な説明":"(具体的な説明1)"}\n{"事業内容":"(事業内容2)","具体的な説明":"(具体的な説明2)"}""",
    })

Promptクラスに埋め込んでしまっていますが、以下のようにプロンプトの構成要素をつなげています。

def export(self,provided_text):
    constraint = "#### 注意事項"+"\n"+" * "+("\n"+" * ").join(self.constraints_list)
    system_prompt = self.instruction+"\n\n"+constraint+"\n\n"+self.output_format+"\n\n"+"#### 例"+"\n"+self.example
    user_prompt = "#### 文章"+"\n"+provided_text+"\n\n"+"#### 回答" +"\n"
    return system_prompt,user_prompt

Groqを用いて生成AIで事業内容を抽出します。Groqはモデルごとにレート制限が1分単位と1日単位であります。1日単位の制限も秒単位で回復していくため少し待てば応答してくれますが、そこそこ時間がかかるため、引っかかった場合にはモデルを変更するか諦めて寝ましょう。

your_api_key_groq: str = input("Please input your Groq API key: ")
GroqAPI_obj = GroqAPI(api_key=your_api_key_groq)


def extract_business_description(sr:pd.Series)->list:
    sys_prompt,usr_prompt = prompt_ext_business.export(provided_text=sr.text_processed)
    response = GroqAPI_obj.request(sys_prompt=sys_prompt,usr_prompt=usr_prompt,model_name='llama-3.1-8b-instant')
    if not response.output_json_validation():
        sleep(1)
        response2 = GroqAPI_obj.request(sys_prompt=sys_prompt,usr_prompt=usr_prompt,model_name='llama-3.1-8b-instant')
        if not response2.output_json_validation():
            print("Error")
            return []
        else:
            response = response2
    output_json_list = response.extract_output_json()
    return output_json_list

# レコードそれぞれについて生成AIで事業内容を抽出
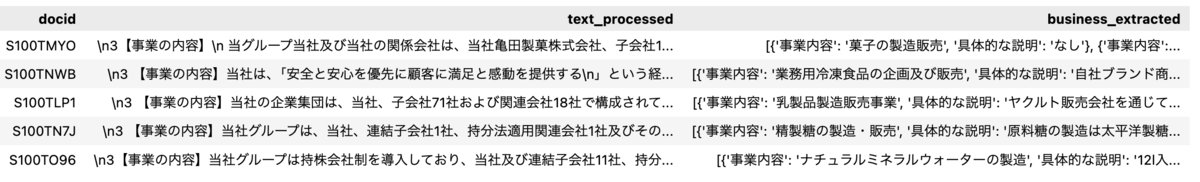
business_desc_df['business_extracted'] = business_desc_df.apply(extract_business_description,axis=1)
# 抽出した内容を少し確認
business_desc_df.head()[['docid','text_processed','business_extracted']]

生成AIによる事業内容の抽出結果

事業内容を抽出できました。抽出した事業内容は5.2で使います。

5. 財務数値の分析

5.1. 棚卸資産の内訳の可視化

これまでテキストデータの分析が続いていましたが、数値データ(金額)の分析です。

BSを抽出し、棚卸資産データを抽出します。日本語のラベルはlabel_jpカラムにあるため、pandas.DataFrame.value_counts()などで検索しましょう。 しっかり分析したい場合は、スキーマと要素名を結合したインデックスがkeyカラムにあるため、これで抽出してください。スキーマと要素名は金融庁のサイトからダウンロードできる勘定科目リストで調べることができます。

# BSの抽出
bs_df = fs_tbl_df_all.query("non_consolidated_flg==0 and current_flg==1 and role.str.contains('BalanceSheet')")
# 在庫の抽出
inventory_df = bs_df.query("label_jp.str.contains('商品及び製品') or label_jp.str.contains('仕掛品') or label_jp.str.contains('原材料及び貯蔵品')")

数値データの前処理をします。テキスト同様に形式的な処理なのでedinet_xbrl_prep.preproc_nlp()に処理を入れ込んでしまっています。他の処理をしたい方は自作しましょう。なお、ここでは提出者名とラベル情報を結合キーにしていますが、"docid"と"key"の方が望ましいです。

# 数値データの前処理
inventory_df = preproc_num(inventory_df) # テキストを数値に変換など
inventory_df_filled = fill_df(inventory_df) # 欠損値の補完
# ピボットテーブルの作成
inventory_df_pivot = pd.crosstab(index=inventory_df_filled['filerName'], columns=inventory_df_filled['label_jp'], values=inventory_df_filled['data'], aggfunc='sum',normalize='index')

ちなみに、有価証券報告書に金額0が入っている場合は表示桁数に満たない金額で存在しています(その他に含めず独立掲記しなければならない場合など)。そのため、次のようにもともと0が入っている場合は表示桁数 x 0.5で埋めて、値が入っていない場合を0で埋めます。

df.data = df.data.fillna(-1) # いったんNoneを-1に退避
df.data = df.data.replace(0,np.nan).fillna(0.5*10**(df['decimals'].astype(float)*-1)) # 0をNoneに置き換えて、表示桁数 x 0.5で埋める
df.data = df.data.replace(-1,0) # -1を0に置き換える

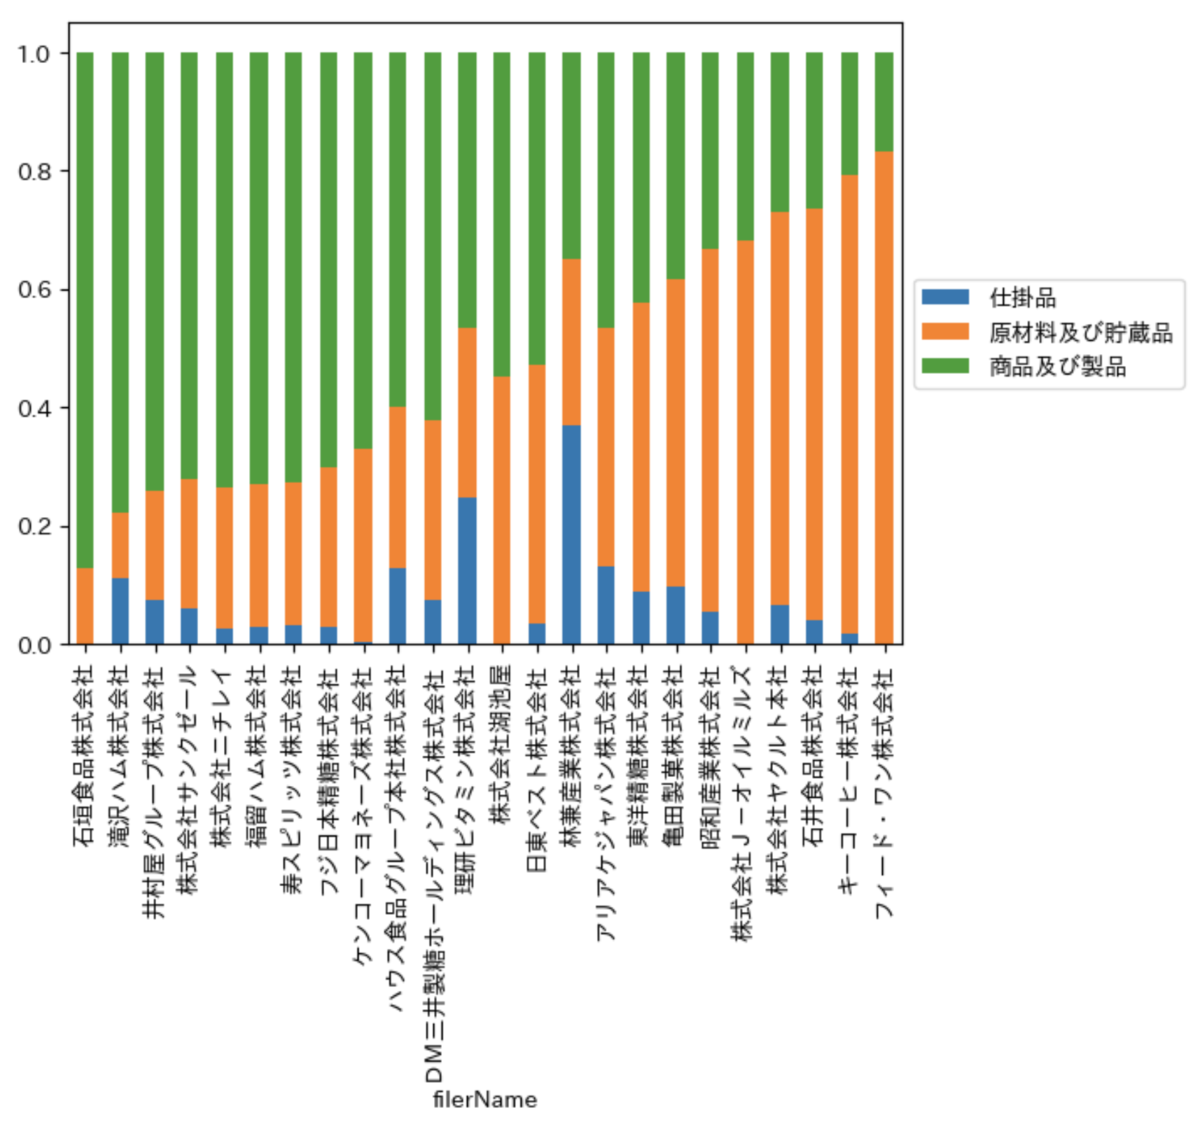
棚卸資産の内訳を比較しやすいように、内訳が類似している企業が近くなるように第一主成分で並べ替えます[注3]。並べ替えたデータで積み上げ棒グラフを作成します。完成品の在庫量が比較的大きい企業とそうでない企業があることがわかります。

棚卸資産の内訳

5.2. 棚卸資産の内訳と事業内容

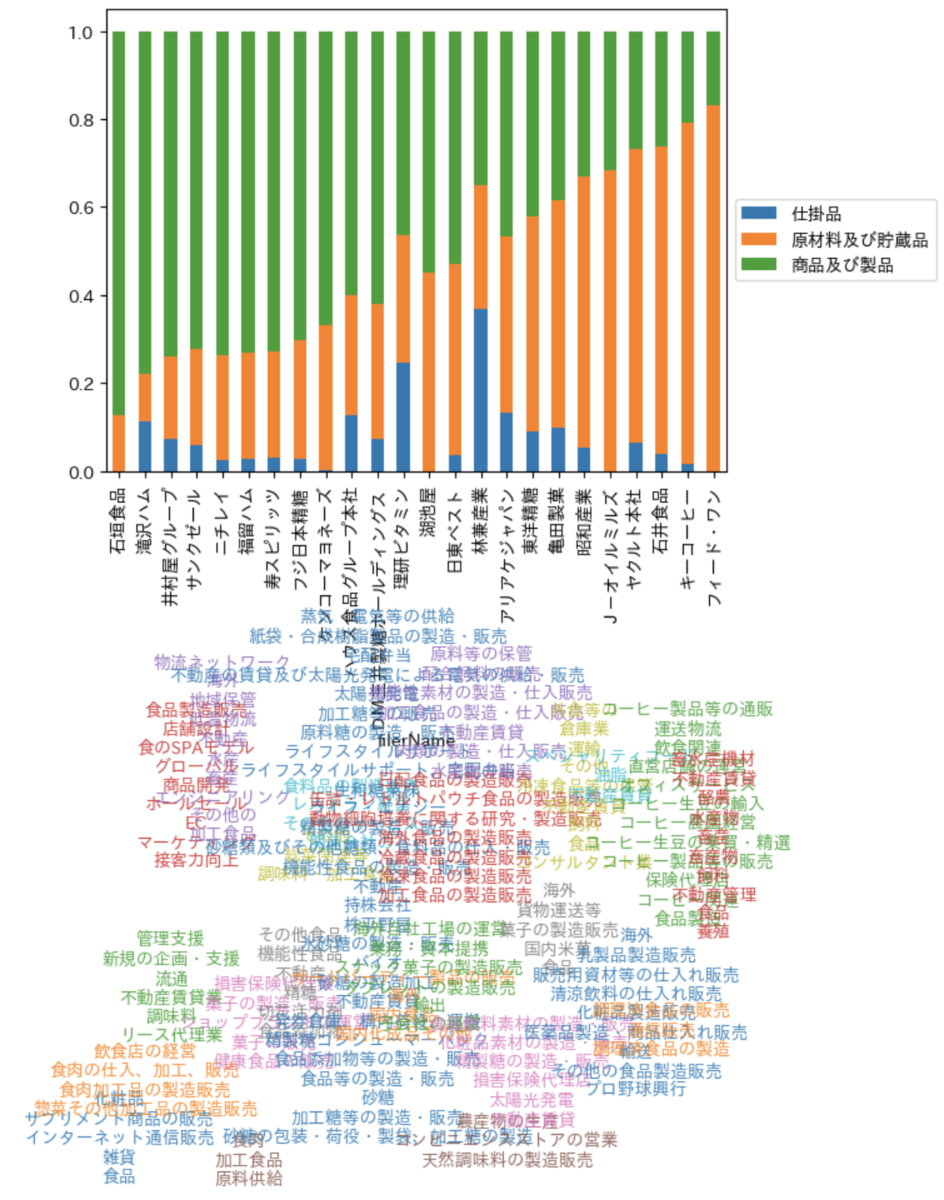
では、完成品の在庫量の大きい企業、小さい企業はどのような事業でしょうか。さきほど取得した事業内容を整列させて図示してみます。

# 4.2で取得した事業内容を結合
reordered_inventory_df_pivot2 = pd.merge(
    reordered_inventory_df_pivot,
    business_desc_df.set_index('filerName')[['business_extracted']],
    left_index=True,
    right_index=True,
    how='left'
)

事業内容と一緒に描画します。いい感じにばらけるようにyの値を調整しています。

棚卸資産の内訳と事業内容

完成品の割合が大きい会社はお肉や加工食品を扱う事業である傾向がなんとなく読み取れます。

5.3. 営業利益率の分析

もう一つ財務数値の分析をしてみます。

# PLの取得

pl_df = fs_tbl_df_all.query("non_consolidated_flg==0 and current_flg==1 and role.str.contains('StatementOfIncome')")

営業利益率算定のために、営業利益と売上高、規模との関係をみるために総資産の金額を取得して、5.1同様の前処理をします。 事業セグメントごとのレコードも入ってしまっていますが、context_refに「_XXXXXXX」のような追加がされているものなので、コンテキストをアンダーバーで区切った要素数が一番短いものに絞ることで除外しています。

# PLから営業利益の取得(売上、総資産も同様)
profit_df = pl_df.query("label_jp.str.contains('営業利益又は営業損失(△)')")
profit_df = preproc_num(profit_df)
profit_df = profit_df.sort_values('context_ref_len',ascending=True).drop_duplicates(keep='first',subset=['docid','key']) # コンテキストをアンダーバーで区切った要素数が一番短いものに絞る
print(len(profit_df))

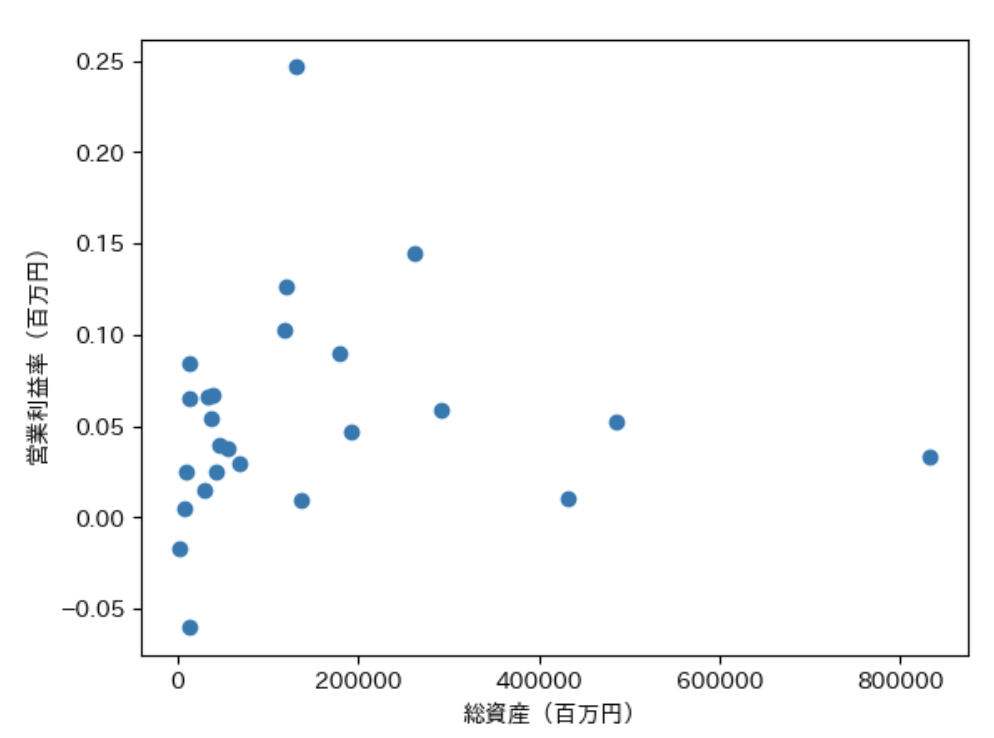
散布図を描画します。

営業利益率と総資産の散布図

規模が大きいほど営業利益率が大きい傾向がなんとなく読み取れます。規模の経済でしょうか。事業内容によっても変わりそうなのでなんとも言えません。

5.4. BS科目の多変量分析(独立成分分析)

せっかく大福帳データをつくったのに、特定の科目に着目した分析のみでは勿体無いです。そこで、BS科目全体の変動パターンを分析してみます。 当期のBSと前期のBSを抽出し、5.1と同様の前処理をします。

# 当期BSの抽出
bs_cy = fs_tbl_df_all.query("non_consolidated_flg==0 and current_flg==1 and role.str.contains('BalanceSheet') and label_jp != '-'")
# 前期BSの抽出
bs_py = fs_tbl_df_all.query("non_consolidated_flg==0 and prior_flg==1 and role.str.contains('BalanceSheet') and label_jp != '-'")
# 数値データの前処理
bs_cy = preproc_num(bs_cy).sort_values('context_ref_len',ascending=True).drop_duplicates(keep='first',subset=['docid','key']) # context_refが短い
bs_cy_filled = fill_df(bs_cy)

bs_py = preproc_num(bs_py).sort_values('context_ref_len',ascending=True).drop_duplicates(keep='first',subset=['docid','key'])
bs_py_filled = fill_df(bs_py)

増減額を計算します。規模を揃えるために当期の総資産で割っています。

# 前期金額カラムを結合
cy_py = bs_cy_filled.set_index(['filerName','key']).join(
    bs_py_filled.set_index(['filerName','key']).rename(columns={'data':'data_py'})[['data_py']]
    ,how='left'
    )
# 総資産金額カラムを結合
cy_py = pd.merge(
    cy_py.reset_index(),
    bs_cy_filled.query("key == 'jppfs_cor:Assets'").set_index(['filerName','key']).rename(columns={'data':'total_asset'})[['total_asset']],
    on=['filerName'],
    how='left'
    )
# 総資産金額でスケーリングした増減を計算
cy_py = cy_py.assign(
    data_diff=(cy_py.data - cy_py.data_py) / cy_py.total_asset,
)

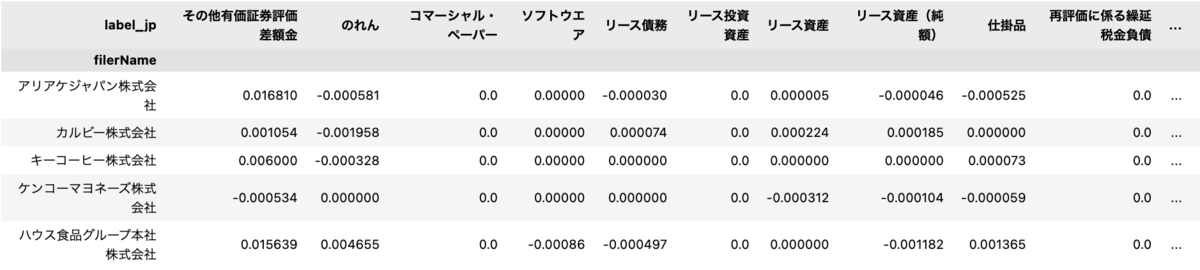
次のようにカラムに勘定科目をもつ表データが作成されます。

スケーリングしたBS増減ベクトル

多変量分析は独立成分分析(ICA: Independent Component Analysis)を用います。scikit-learnにあるので簡単に使えます。

ICA = FastICA(n_components=10, random_state=0)
X_transformed = ICA.fit_transform(cy_py_pivot)

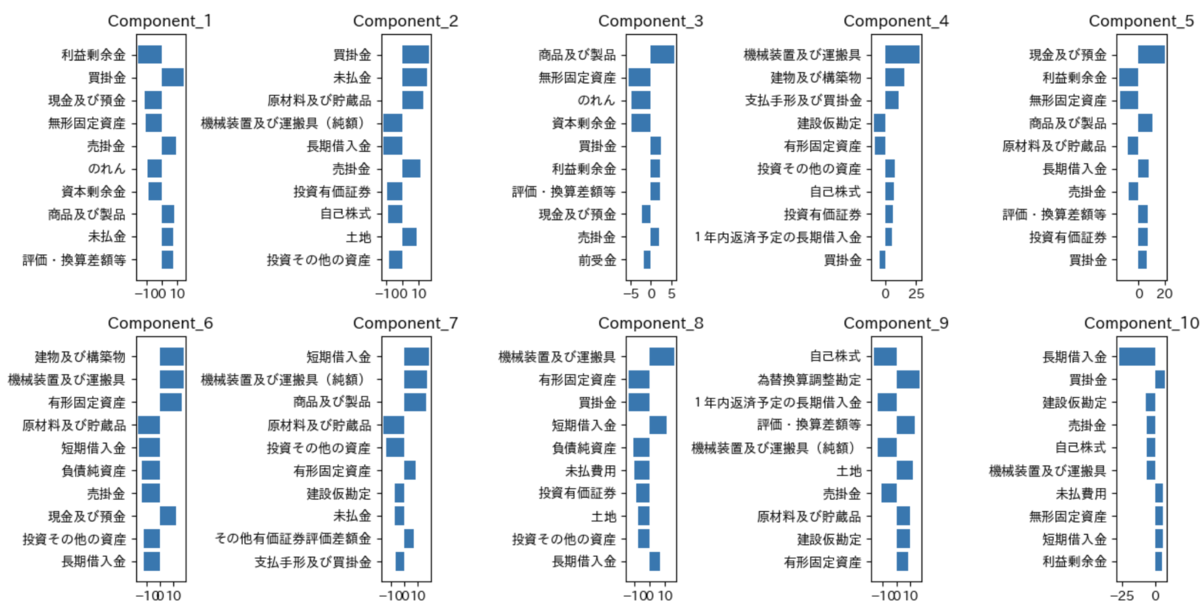
独立成分分析の各成分を図示します。

BS科目の変動成分

データサイズが小さいので、あまり綺麗に分かれず解釈が難しいですが、Component_1は全体的な変動、Component_2は仕入、Component_4は設備の完成、Component_7は設備投資あたりでしょうか。ちょっと苦しいですね。

6. XBRLデータをデータベースに出力して生成AIに分析してもらう(Claude+MCPを利用した分析)

MCPは、例えばコンピュータのローカルのデータベースに接続してデータを抽出するといった外部アプリ連携を生成AI(Claude)に提供します。つまり、人間が分析する必要がなくなります。私の仕事がなくなる日も近いですね。

MCPでClaudeにデータを与えて分析してもらうために、SQLiteというデータベースファイルにXBRLデータを出力します。 テキスト情報が多い前段部分と財務数値部分を別のテーブルに分けて出力しました。

import sqlite3
file_sqlite3 = DATA_PATH / "xbrl_parsed.db"
conn = sqlite3.connect(str(file_sqlite3))
fs_tbl_df_export_ci.drop('data_str',axis=1).to_sql('corporate_information',conn,index=None,if_exists='replace') # 前段
fs_tbl_df_export_num.to_sql('xbrl_parsed',conn,index=None,if_exists='replace') # 財務数値
conn.close()

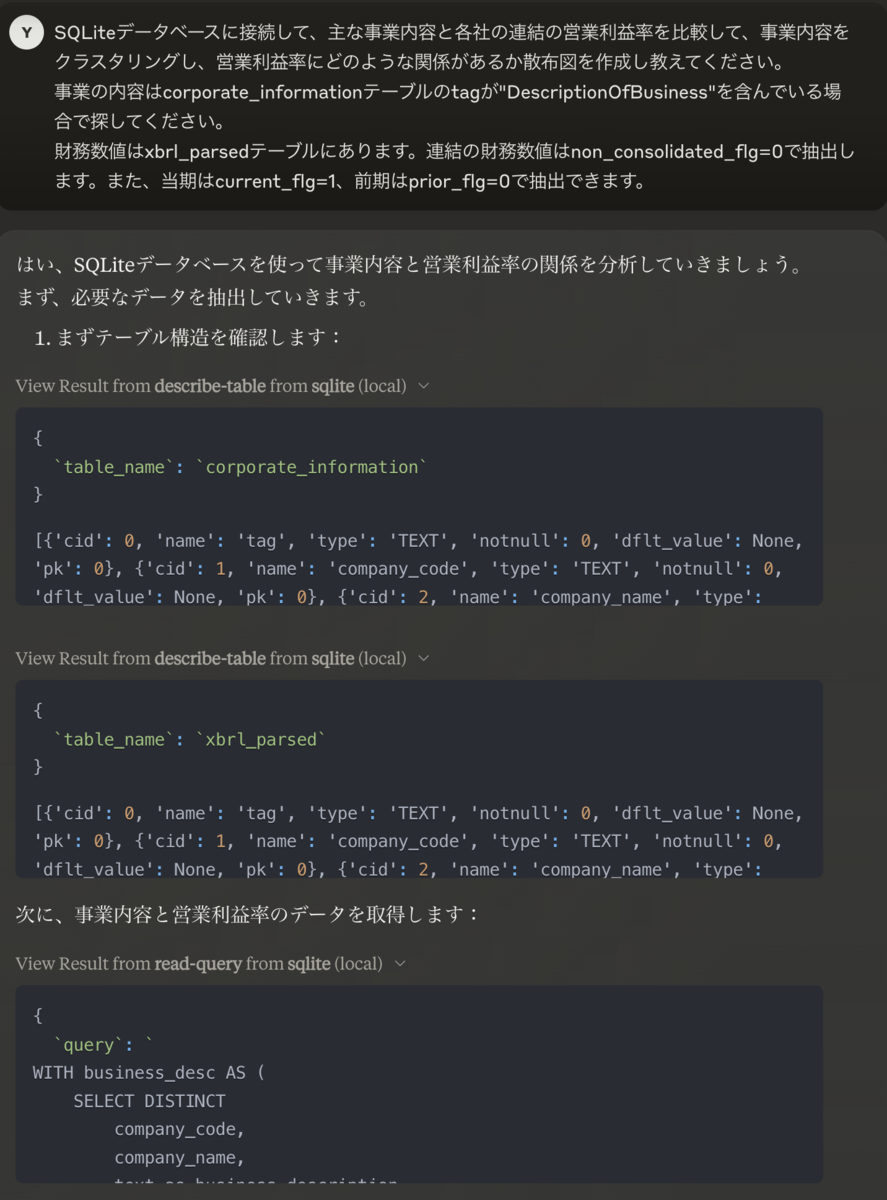
以下のプロンプトを与えて、Claudeに分析してもらいます。

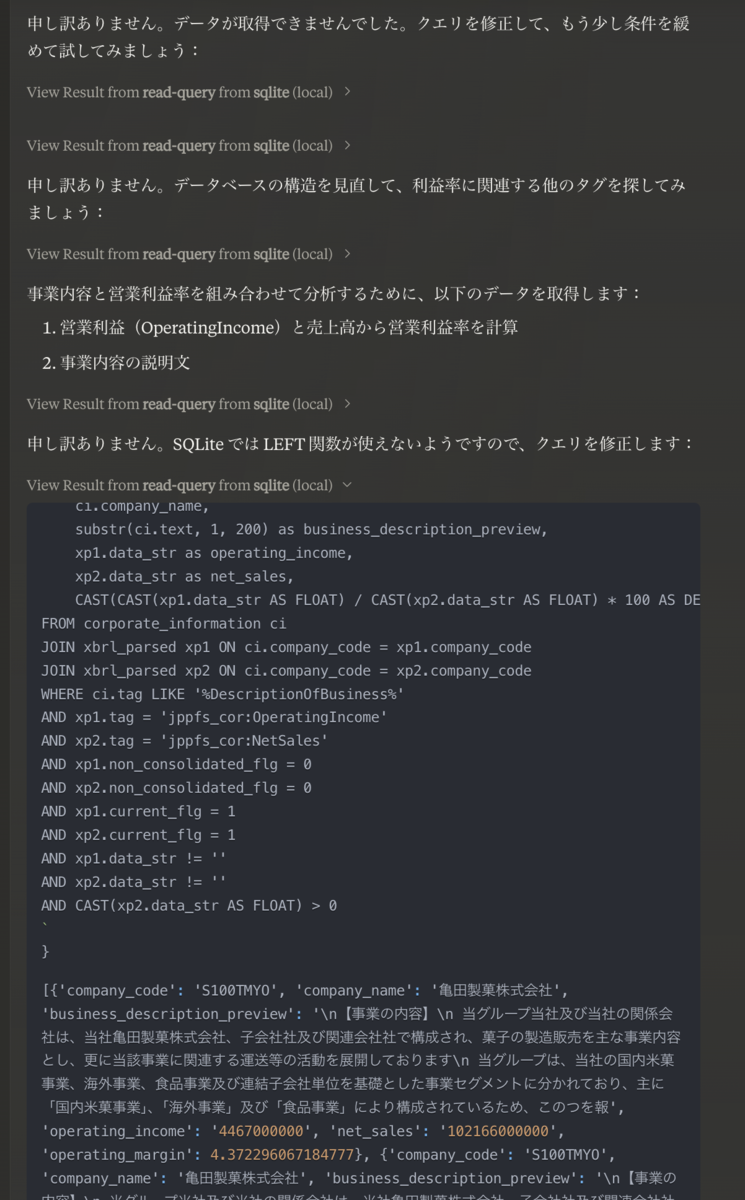
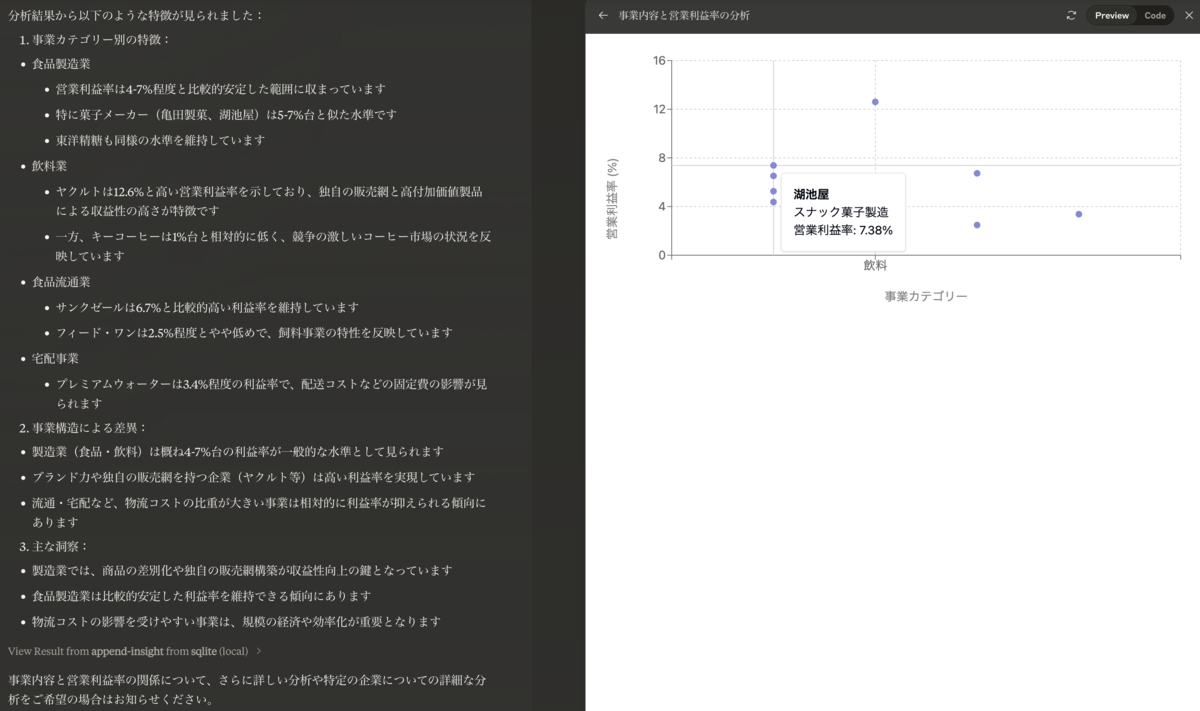
SQLiteデータベースに接続して、主な事業内容と各社の連結の営業利益率を比較して、事業内容をクラスタリングし、営業利益率にどのような関係があるか散布図を作成し教えてください。
事業の内容はcorporate_informationテーブルのtagが"DescriptionOfBusiness"を含んでいる場合で探してください。
財務数値はxbrl_parsedテーブルにあります。連結の財務数値はnon_consolidated_flg=0で抽出します。また、当期はcurrent_flg=1、前期はprior_flg=0で抽出できます。

うまくいかずに何度も何度か試行錯誤し、テーブルのカラム名をわかりやすい一般的な名称にしたり、不要なカラムは削除しておくことでなんとか分析させることができました。 とはいえ、クエリの失敗が多いので、テーブルメタデータやクエリの例とか与えてあげるとスムーズに行くのではないかと思います。

以下、Claudeの出力です。クエリで失敗しているところは省いています。

Claudeの出力1
テーブル構造を確認して、クエリを作成しています。

Claudeの出力2
クエリを書いてデータを抽出しています。失敗部分は折りたたんでいますが、だいたいはクエリの結果として空のデータが出力されています。最後になんとか抽出できたようです。

Claudeの出力3

図の右側に散布図がありますが、マウスオーバーで抽出した事業内容を表示できるインタラクティブな可視化を作成してくれます。

まとめ

XBRLデータを分析しやすい大福帳(One Big Table)データにすることで、さまざまな分析のハードルが下がります。また、生成AIにとっても扱いやすいデータになります。 皆様も色々分析してみてください。読んでいただきありがとうございました。

注

注1 環境構築

なお、筆者はuvで環境を構築しているので、その方法だけ記載しておきます。
0.1.1 uvのインストール

brew install uv

0.1.1 プロジェクトの作成します。

cd projectフォルダを作成したいフォルダ
uv init プロジェクト名
cd プロジェクト名

0.1.2 プロジェクトの作成します。 プロジェクトを作成すると自動作成されるpyproject.tomlを編集します。requires-pythonとdependenciesを以下に書き換えます。

requires-python = "==3.12"
dependencies = [
    "arelle-release>=2.35.17",
    "gensim>=4.3.2",
    "groq>=0.13.1",
    "ipykernel>=6.29.5",
    "janome>=0.5.0",
    "japanize-matplotlib>=1.1.3",
    "matplotlib-fontja>=1.0.0",
    "matplotlib>=3.10.0",
    "pandas>=2.2.3",
    "pandera>=0.21.1",
    "requests>=2.32.3",
    "scikit-learn>=1.6.0",
    "scipy==1.12",
    "seaborn>=0.13.2",
    "setuptools>=75.6.0",
    "tqdm>=4.67.1",
    "wordcloud>=1.9.4",
    "xlrd>=2.0.1",
]

0.1.3 仮想環境を作成します。

uv sync

uvについては以下が大変参考になります。

zenn.dev

注2 XBRLデータの抽出の難しいところ

XBRLはエクセルのようにかなり自由なデータ形式です。自由な形式ほどデータ抽出は困難を極めます。データの抽出精度が9割でよければ簡単ですが、これを10割にするのはものすごく大変です。例えば、有価証券報告書のPDF(やインラインXBRLというhtmファイル)にはあるものの、XBRLインスタンスに含まれていない項目があったり、誤解しやすいタグを使っていたりするケース(提出者のミスなのか行き過ぎた自由なのか)が散見されます。こういうのは生成AIで検知する仕組みを作りたいですね。また、公開しているソースコードではイレギュラーなXBRLは扱えていませんので、今後アップデートしていきたいと思います。

注3 組成データの距離について

合計が1になる内訳データは組成データと呼ばれており、組成データ用の分析手法があります。例えばAが10%とBが20%の場合とAが20%でBが40%の場合はどちらもBがAの2倍という点で類似していますが、そのままユークリッド距離を計算するとこの点が反映されません。そこで、比率関係をの類似性を扱うスケーリングを施したAitchison距離が提案されています。 しかしながら、今回扱う財務データ(金額)には欠損や0値、相対的にすごく小さい値があり、Aitchison距離はあまり適していません。また、今回は小さい値は重要でないことから、通常のユークリッド距離を用いて(主成分分析をして)います。

注4 XBRLデータ抽出の参考になるページ

99までの知識に興味がある方は以下が参考になります。網羅的に調査できていないため、紹介できていないブログ等ありましたらごめんなさい。

一般社団法人 XBRL Japan - XBRL Japan Inc. - XBRLのテクノロジー
XBRLの様々な情報が調べられます。

シラベルノート | 業績から株式銘柄の良さを調べています。決算分析のコード例は『XBRLまとめ』からどうぞ。
筆者は2018年頃からEDINETのXBRLデータの前処理と定期的に戦っていましたが、このブログをずっと後追いしていました。Arelleもこのブログで知りました。大変お世話になりました。

財務分析に欠かせない、XBRLを読む: タクソノミ文書編|piqcy
タクソノミの説明がわかりやすいです。仕様書が丁寧に解説されています。まだ情報が少ない中の公開で大変お世話になりました。

ゼロから始めないXBRL解析(Arelleの活用)
Arelleの公開情報が少ないため参考になります。コメントに読み方も書いてあります。

Pythonで学ぶXBRL入門:KB農園
最近出版されているため、pythonやライブラリのバージョンが新しく実践しやすいと思います。

PythonとExcelによるXBRL解析 株式投資に役立つ財務分析の準備
こちらも最近出版されており、実践しやすいと思います。

【祝・合格🎊 】(会計人材だけど AI・データサイエンスがしたい方向け)監査法人でAIやデータ分析に取り組むには


https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEjLhF-LWzZ5iGrx41RWeAd8lzNXukl3fDz990FYRYzJzw3mc1y4Dj4hzRx85hBtuIiEiBsqpRDveM-p4ArAy5pdw4otAPuk1YAMfQDylvKjbddFt24PF94UruvXBcr6v9O7EzPThBCirv-i/s800/bg_namikimichi1_sakura.jpg

公認会計士試験合格おめでとうございます!
試験で養われた幅広い知識と自己管理や時間配分、試験戦略など工夫した経験は今後様々なところで役に立ちます。自信を持ってください。そして、これまでは試験科目という限定された分野でかつ試験対策のための勉強を迫る試験日のプレッシャーの中行う日々だったと思いますが、今後は知的好奇心の赴くままに好きなことを自由に勉強できます。

このリレーメッセージでは様々な執筆者が寄稿していますが、そこからもわかるように、会計士試験合格者のキャリアは多様です。私は、現在は事業会社で研究開発やマーケティングのデータ分析をしています(一般的な試験合格者のキャリアパスから大きく外れています)。
私が皆様にお伝えできることはほとんどないのですが、一つだけ伝えるとすれば、公認会計士試験合格はキャリアを縛るものではないということです。もちろん、公認会計士試験合格を活かすほうが断然お得ですが、それに縛られず自由に挑戦していって自分の思い描く"プロ"になってください。

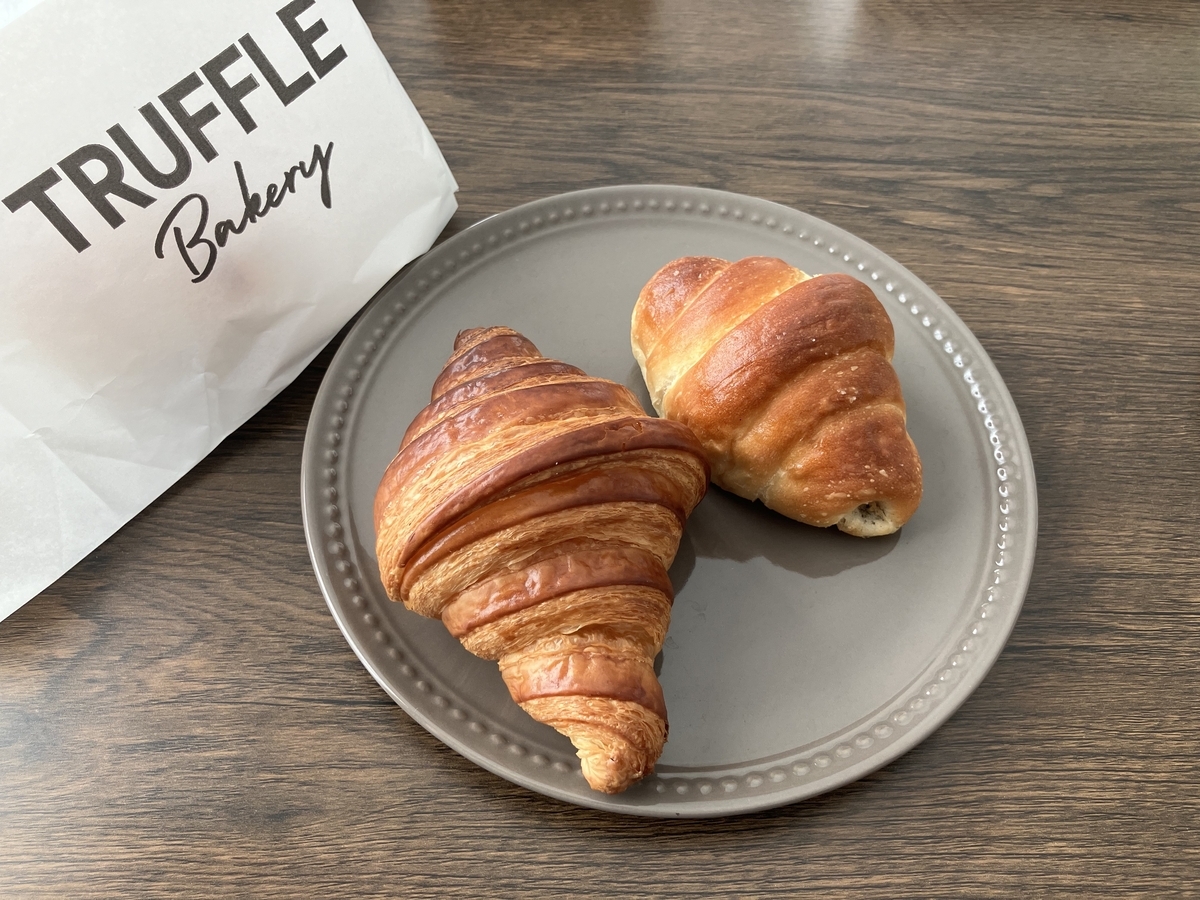
このブログはてりたま先生企画<【祝・合格🎊】X会計士界隈から論文式試験合格者の皆さんへのリレーメッセージ>の#24 の記事として寄稿させていただきました。 明日は、楢木 毅/公認会計士/CFO 先生)です。お楽しみに! ちなみに、楢木先生がCFOをされているTruffle BAKERYの白トリュフの塩パンが私の嗜好にストライクで、お店を伺ってきました。美味しかったです!

塩トリュフの塩パン(右)とクロワッサン(左)♪


...


はい!、今ここに残っている方は、タイトルの内容が全然書かれていないぞと気になった職業的懐疑心の持ち主か、AIやデータサイエンスに興味を持っている方でしょう。

それでは、監査法人におけるAIやデータ分析に関連した業務について、監査法人に勤めていた時を思い出しつつ、最近のAI分野の状況も踏まえてお話しします。監査法人でAIやデータ分析に関わりたい方の参考になれば幸いです。(1つくらいこういうニッチなメッセージがあってもいいですよね!)

監査におけるAIやデータサイエンスとは?

監査でAIやデータサイエンスがどのようなところで使われているかをざっくり調べるために、KAM(監査上の主要な検討事項)のデータをEDINETから取得し、自然言語処理と生成AIで要約しました(手法は[注1])。(長いのでプルダウンを展開してください)

ある程度の例は取ってこれたと思います。 一方で、「工事進捗度予測ツール」など筆者が認識しているものが漏れてしまっているため網羅性はありません。また、監査サンプリングは統計学を応用しているものの表立ってAIやデータサイエンスが使われていません。 ちなみに、EYさんの事例が多めですが、KAMへ積極的に記載しているようなので、必ずしも導入の多さを意味するわけではありません。[注2]


また、このリレーメッセージを企画されたてりたま先生のブログも非常に参考になります。 note.com

結論: 監査法人でAIやデータサイエンスの業務をするには?

公の場では監査法人はどこも「AIやデータサイエンスの活用が進んでいる!」のようなアピールをしています。しかし、実際にこれらが監査するアサーション(監査要点)に適合し、意見形成や指摘事項(指導)の発見に貢献できているかというとそのようなケースはあまり多くはないのではないかと思います。

ここで結論を書いてしまいますが、監査へのAIやデータサイエンスの応用は、以下3つの要因に大きく左右されます。
1. 分析ツールや分析環境の有無
2. クライアントの事業との相性やデータ品質
3. 現行基準との相性と周囲の理解

一言でまとめると、配属される監査チーム(とクライアント)に強く依存します。

来年度入社でこの方向でキャリアを検討されている方は、人事の方に相談してみることを推奨します。
以下では、これら3つの要因について詳しく説明していきます。

要因 1. 分析ツールや分析環境

ここに記載している事項は筆者の想像を多く含んでいます。

1.1. 監査法人で開発した共通分析ツールを監査チームが利用

監査法人としてAIやデータ分析の共通分析ツールを開発しています。監査法人が自身のホームページ等で紹介しているような監査へのAI活用の取り組みの多くはこのケースに該当すると思います。

共通分析ツールはBIと似ています。BIは、データを読み込ませると、自動で集計、可視化、UIが作成できるツールです。 監査チームのメンバーは共通分析ツールから提供された集計や可視化から、異常がないか等を見て監査に利用します。 集計や可視化では、着目する変数を指定したりすることで、監査人独自のデータを見る切り口で分析することができます。もちろん、データを見る切り口は業界である程度共通ですが、クライアントの事業形態によって柔軟に変えると良いでしょう。 このようなツールの導入は、私が監査法人に入所した6年前頃でも各法人ですでに盛んに行われているようでしたので、現在では導入できるところには導入されていることでしょう。 監査チームメンバーとして共通分析ツールを用いる作業を担当することで、使うことができます。

最近の状況は詳しくわかりませんが生成AIツールも共通分析ツールの一つとして提供されているようです。[注3]

一方で、このような共通分析ツールでは、予めツールに実装されていない分析はできませんので、次の1.2や1.3のような環境で独自に開発する必要があります。

1.2. 監査チーム内で自分で開発する場合

自分で分析する場合、pythonやR等のプログラム言語が利用できる環境が必須です[注4]。 作業用のPCはセキュリティのために、自由にツールを入れることは基本的にできないと思いますので、依頼して自身のPCにインストールするか、ツールがインストールされた別のコンピュータ環境(別のパソコンか仮想環境)を作成してもらいます。 環境を用意してもらう場合には監査チームの主任や所属部署のパートナー、環境管理部署の承諾を得る必要があるでしょう。

1.3. 監査チームがAIやデータ分析を内部専門家に依頼または共同開発する場合:

監査における内部専門家の利用として分析者と共同で進める場合で、事業会社の分析業務でよくある形になります。 基本的に分析者に手を動かしてもらいます。監査チームでは提供された分析結果を評価して監査証拠として利用します。 手を動かすのが分析者であるだけで、分析内容や結果の評価は監査チーム担当者が行うため、AIやデータ分析の知識を使用します。 監査チーム側の担当者として関わることができますが、監査やクライアント、分析に関する知識がある程度ないと、任せきりになってしまいがちです。

分析環境を申請したりAIやデータ分析関連の監査要点を担当するには、周りの協力が必要ですので、配属される監査チーム次第というところがあります。

要因 2. クライアントの業態との相性やデータ品質

2.1. クライアントの業態との相性

監査におけるAIやデータ分析の活用しやすさは、クライアントの業態によって影響されます。

AI・機械学習では、データのばらつきを活かした分析を行います。つまり、分析対象が多くの項目から構成されている必要があります。 例えば、KAMの例に挙がっていたガス販売量や検針データの分析が有効なのは、これらが多数の販売先に関するデータだからです。 逆に、売上が数件の大口取引で構成される場合、それらをしっかり検証すればよく、AI・機械学習のメリットを活かせません。

加えて、AI・機械学習では、分析対象の観点を特徴量として、特徴量同士の関係や予測対象と特徴量の関係の考えられる仮説の中から有力な仮説を学習します。

KAMの例では、得意先別、営業所別、構成区分別の売上高のように売上高データに(得意先、営業所、構成区分)といった観点が与えられていたり、与信先に財務情報、業種、支店、地域などの観点が付けられています。 このように、観点の数が多いほど、さまざまな組み合わせの仮説が考えられ、機械学習を活かすことができます。

一般的には以下のようなクライアントではAI・機械学習を活かしやすいでしょう。
- 顧客の数が多い(例えば消費者向けのサービス)
- 同じ事業を長期間行っている
- 会社の事業が多様(勘定科目の種類が豊富)
- 事業拠点(子会社、SPC、店舗)がたくさんある

2.2. クライアントのデータ品質

2.1で説明したような事業であっても、これらの事業のデータが保管されていなければ監査で活用することはできません。

そして、クライアントのデータを分析して監査で利用するためには、データが信頼できる必要があります。

監査では検討対象の偏りや完全性に気を配ります。内部統制の検証であれば収集したデータが目的のデータの母集団に対して異なる選択バイアスを持っていたり、財務諸表監査であれば収集したデータが検討対象の会計金額(実在性の場合)や候補集合(網羅性の場合)の全体になっていなかったりすると、監査に利用しづらいです。

一方で、クライアントのデータ品質は、そのクライアントのデータへの投資状況に大きく依存します。例えば、データ活用に積極的な企業であれば、一元化されたデータベースを作って管理しています。そうでない企業では、データは各部署あるいは担当者が個別に管理されており(いわゆるサイロ化状態)、データを収集するのが大変になってしまいます。近年は生成AIにより自然言語処理が発展し、稟議書や契約書などの案件に関する自然言語データの活用が期待されるものの、自然言語データがデータベース等でしっかり管理できている会社はまだまだ少ない印象です。

クライアント自身がこれらのデータを利用するのに膨大なリソースを割かないといけない状況では監査への応用は難しいと思います。

要因 3. 現行基準との相性と周囲の理解

個人的にはこれが一番重要で悩ましい問題と思っています。

現行の会計や監査の基準において、AIやデータ分析を要求されるケースはほとんどありません。また、基準はAIやデータサイエンスの実施を前提としていません。
現行の基準の枠組みで運用できない場合も出てきてしまいます。
例えば、日本基準を前提に、異常検知で分析した結果いくつかのデータが「通例でない取引」に該当すると解釈できる場合には、「不正による重要な虚偽表示の兆候」としてしっかりと対処する必要があります。異常検知の精度が十分に高くないと、誤検出を多く出してしまい監査人のリソースを浪費してしまうため、現行の監査の基準の要求に耐えられません。

世間一般ではAIは効率化のツールとして利用されることが多いですが、監査の文脈ではあまり効率化として用いられることはありません。 効率化の代償として少しでも品質が落ちてしまうことを恐れているからでしょう。あくまで補完の位置付けで、要求水準の手続に追加する形で分析が行われることがほとんどの印象です。

例えば、AIで取引データに対して虚偽表示確率を予測している場合に、それを補助変数とすることで無作為に選ぶ場合よりも母集団の虚偽表示額を精度高く見積もることができます。これは、言い換えると、補助変数を用いるサンプリングであればより小さいサンプルサイズで目標とする信頼度を達成できるわけですが、このロジックでサンプルサイズを小さくしている例は聞いたことがありません。[注5]
監査サンプリングは外部検査の指摘事項として取り上げられることが多いため、監査基準に準拠した方法を採用するのが無難という判断になるのでしょう。
その結果、AIやデータサイエンスの分析結果から抽出されるサンプルは特定項目抽出の対象として整理して、残余集団について統計的サンプリングを適用し、結果的に、合計のサンプルサイズは大きくなってしまいます。

このように現行の基準との相性がいまいちである一方で、監査の現場は人手に余裕がありません。なぜAIやデータサイエンスの分析が必要なのか理解が得られないと、時間を割くことが難しいでしょう。クライアントに対しても、分析に割いた時間も監査にかかった時間としてクライアントが負担することになるため説明が必要です。 その上、監査チームの主任、パートナー、審査担当者、クライアントで、AIやデータ分析に精通した人材は少なく、関係者の理解を得ることは容易ではありません。

一方で、クライアントの内部監査部や監査役は世間のAIへの期待を反映して、これらの取り組みを高く評価する場合があります。すると、クライアントへの価値提供を重視する監査法人や監査チームでの理解も得られやすく、断然取り組みやすくなります。

このように、 現行基準との相性や周囲の理解も監査チームへの分析導入を左右する大きな要因となっています。

(おまけ)経験談

以上、監査法人でAIやデータサイエンスの業務をする際のポイントについてお話ししましたが、最後に私のケースを簡単にご紹介します。
学生の時の研究でデータ分析経験があったこともありますが、アサイン希望にとても柔軟に対応していただきました(大変ありがたかったです)。

金融系クライアントの多い部署で主に上場企業2社を担当しました。うち1社は、私がアサインされる前から監査へのデータ分析の活用が進んでおり、クライアントからも監査法人からも分析への期待があり、非常にやりやすいチームでした。 消費者向けビジネスなので取引が多く、またそれに関連する会計上の見積もりが必要な科目が複数ありました。会計上の見積もりではAIが使用されており、そのAI及びAIの予測の監査ではベイズ統計モデリング、説明可能AI、感度分析といった当時では最先端の応用ができました。 そこでは1.1の共通ツールに加え、1.2のような独自の分析環境が用意していました。さらに、1.3に書いたように専門家の利用として分析担当者もアサインしていましたが、私も一緒に分析作業もさせてもらいました。データの品質も高かったです。その結果、分析も監査要点に対応していて、意見形成への貢献度が高い取り組みができていました。
もう1社はというと、事業者向けビジネスで契約や事業拠点が多くあったため、クラスタリングや異常検知の分析を行いました。そこでも1.1. のような分析の共通ツールの導入はでき、私自身にも1.2.のような環境を用意してもらい独自の分析を行っていました。しかしながら、リソース、データ品質、周囲からの関心の低さゆえに、深い導入まではできていませんでした。
あとは会計監査ではないのですが、AIやデータサイエンス関連のコンサルティング業務にも一部関わらせていただきました。

まとめ

監査へのAIやデータサイエンスの活用はチャレンジングな領域です。どこまで活用できるかは周りの環境に大きく左右されてしまいます。
一方で、AIやデータ分析で何の監査要点を解いているのか考えることで、監査と技術の双方への理解が深まります。興味がある方は、ぜひ挑戦してみてください。
読んでいただきありがとうございました。

注

[注1] KAM分析手順

①報告されている会計期間の期末が2023/4/1〜2024/3/31の有価証券報告書提出会社(第3号様式)3,841社の連結の監査報告書(4,656個のKAM)について、EDINETのAPIから取得し、Arelleでパースし、以下タクソノミで監査上の対応テキストを抽出します(一部はタクソノミが誤っていて抽出できないため手作業で抽出しています泣)。

aud_res_taxonomy_list = [
    'AuditorsResponseKAMConsolidatedTextBlock',
    'AuditorsResponseKAMNonConsolidatedTextBlock'
    'AuditorsResponseContinuedKAMConsolidatedTextBlock',
    'AuditorsResponseContinuedKAMNonConsolidatedTextBlock',
    'AuditorsResponseContinued2KAMConsolidatedTextBlock',
    'AuditorsResponseContinued2KAMNonConsolidatedTextBlock',
]

Arelleを用いたXBRLデータのパースまでの流れを知りたい方は以下が参考になると思います。一緒にPyはじを執筆させていただいたかばにゃす先生が著者の一人です。 techbookfest.org

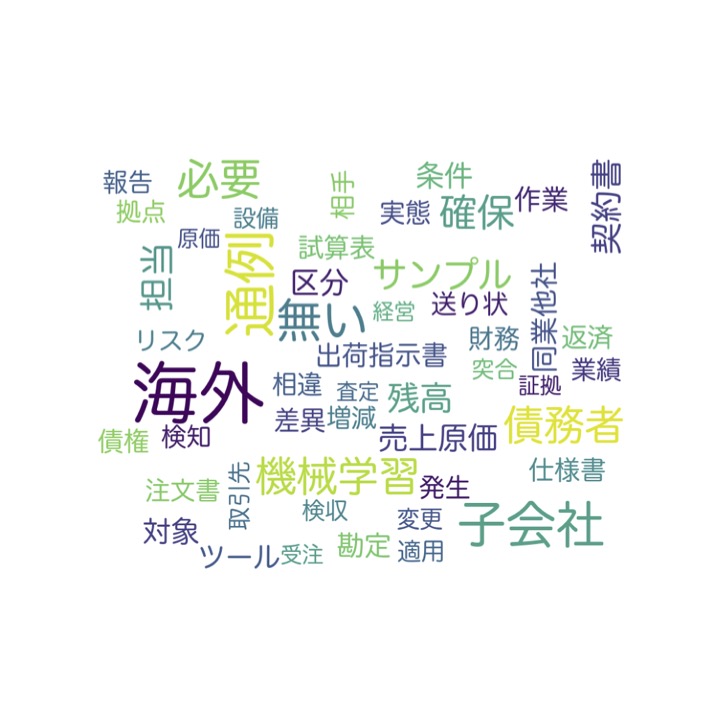
②監査上の対応テキストをSudachiでトークン化し、LDA (Latent Dirichlet Allocation)で400個のトピックに分解します。 構成単語に分析関連ワードが含まれているトピックを抽出し、監査上の対応テキストのうち、それらのトピックのスコアが0.1以上のものを抽出します(179件)。

keyword_list = ["機械学習","データ分析","AI","ツール"]

"機械学習"を含むLDAトピックの構成単語

③GPT-4o-miniを用いて、これらの監査上の対応テキストから、監査人がAIやデータサイエンスを利用している手続を以下プロンプトで抽出します。OpenAIのBatch APIで1.5円くらいです笑(安く済むなら②で絞らずにもう少し網羅してもよかったです)。

提供された文章に記載された事項から、監査人が行う監査手続にAI・機械学習、統計学、データサイエンスの手法を用いられているケースを抽出してください。 
#### 注意事項
 * できるだけ文章中の記載をそのまま引用してください。
 * ない場合は{"ケース":"なし"}と回答してください。
#### 回答形式
フォーマットは個別のjson形式で回答してください。 {"ケース":"(ケース1)"} {"ケース":"(ケース2)"} 

#### 文章 
${ここに監査上の対応テキストを挿入}
#### 回答

④ Claude 3.5 Opsで要約

提供された手続一覧のうちAIやデータサイエンスの手法を用いている手続をいくつかのトピックに整理してください。 重複しているものを除き、できるだけ元の文章を残してください。 改行は<br>で表記してください。 引用する際は、引用部分を「」で囲み、以下のフォーマットで引用元を明示してください。
#### 引用フォーマット 
「引用部分」((出典: XX監査法人(20XX) 独立監査人の監査報告書及び内部統制監査報告書 XX会社))
#### 手続一覧
${③の出力に出典情報をつなげたものを改行区切りで結合してここに挿入}
[注2]

例えば、こちらではKAMへの記載を導入実績としており、KAMに分析関連の内容を積極的に記載するインセンティブが働いている可能性があります。

[注3]

以下に参加してそんな話を聞いてきました(資料が非公開なので具体的な内容はここに書きません)。ちなみに、2025年の2月の開催も検討しているようです。 www.carf.e.u-tokyo.ac.jp

[注4]

監査法人で使うExcelでpythonが利用できるようになれば、環境を作らなくてもある程度の分析ができるようになると思います。しかしながら、一時的にMicrosoftのクラウド環境にデータを転送して実行するようなので、そのままでは利用できない可能性もあります。

support.microsoft.com

[注5]

補助変数を用いた監査サンプルサイズの削減については、以下の4.7.3で具体例が説明されています。 koenderks.github.io

以下はKAMの出典です

*1:出典: 有限責任監査法人トーマツ(2023) 独立当監査法人の監査報告書及び内部統制監査報告書 ヤマシタヘルスケアホールディングス株式会社

*2:出典: EY新日本有限責任監査法人(2023) 独立当監査法人の監査報告書及び内部統制監査報告書 ユーピーアール株式会社

*3:出典: 東邦監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 京葉瓦斯株式会社

*4:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 日本マクドナルドホールディングス株式会社

*5:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 ダイワボウホールディングス株式会社

*6:出典: 有限責任監査法人トーマツ(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 静岡ガス株式会社

*7:出典: PwC Japan有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社エプコ

*8:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社安川電機

*9:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社琉球銀行

*10:出典: 太陽有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社松屋

*11:出典: 有限責任監査法人トーマツ(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 NISSHA株式会社

*12:出典: 有限責任 あずさ監査法人(2023) 独立当監査法人の監査報告書及び内部統制監査報告書 サンネクスタグループ株式会社

*13:出典: 有限責任監査法人 トーマツ(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 京極運輸商事株式会社

*14:出典: 仰 星 監 査 法 人(2023) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社ジェイテックコーポレーション

*15:出典: PwC Japan有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社Jストリーム

*16:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 株式会社南日本銀行

*17:出典: EY新日本有限責任監査法人(2024) 独立当監査法人の監査報告書及び内部統制監査報告書 尾家産業株式会社

大規模言語モデルによる帰納的学習を多クラス文書分類へ応用する実験


先日、金融情報学研究会SIG-FINで以下の発表がされていました。

大規模言語モデルを用いた金融テキスト二値分類タスクの定義文生成とチューニング手法の提案[1]

www.jstage.jst.go.jp

この論文では、センチメント分析におけるポジティブとネガティブの定義の曖昧さという課題に対して、大規模言語モデル(LLM: Large Language Model)を用いてデータからの定義文を生成するアプローチを提案しています。具体的には以下の2つのステップからなります。

  1. いくつかの訓練データから初期定義文を生成するステップ

  2. 定義文を用いて訓練データを分類し、その誤分類結果から定義文を改善していくステップ

課題に対してアプローチが的確に刺さっていて、とても面白いです。

一方、この論文で提案されているような相性がいい課題と手法の組み合わせではないのですが、一般的な文書分類(多クラス分類)について、2と同様の方法を試してみました。 あまり良い結果ではないのですが、便乗して共有します。このアプローチを試みる方の参考になれば幸いです。

イントロダクション

少し背景を説明します。

文書分類結果からの分類ルールの推定は、事例(以下インスタンス)から概念を獲得する帰納的学習(Inductive Learning)の一形態として捉えることができます。従来の帰納的学習では、概念とその構成要素を形式言語によって厳密に表現することが主流でした。 例えば、以下のような形式言語による規則集合で表現されてきました。

  1. IF-THENルール

    • 条件部と結論部からなる規則ベースの表現
    • 例えば、「鳥は翼を持つ」は「IF x = 鳥; THEN x は翼を持つ」
  2. 知識グラフ(Knowledge Graph)

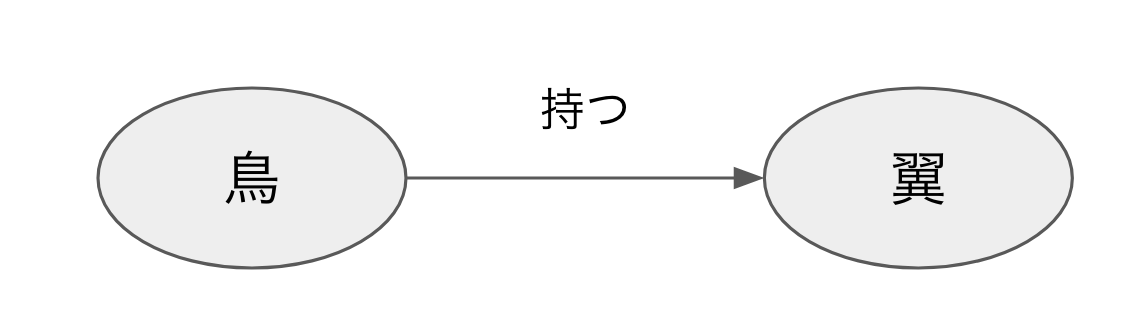
    • 概念を<head, relation, tail>の三つ組で表現。headとtailはものを表すノードの属性、relationはノード同士の関係を表すのエッジの属性。
    • 例えば、「鳥は翼を持つ」は<head=鳥、relation=持つ、tail=翼>

図1 ナレッジグラフの例

  1. 論理プログラミング(Logic Programming: LP)
    • xはFを満たすかを表す関数F(x)と論理式で概念を表現
    • 例えば、「(すべての)鳥は翼を持つ」は \forall x; Bird(x) => HaveWing(x)
    • 帰納論理プログラミング(Inductive Logic programing)という、機械学習により概念の獲得を狙う手法も発展

概念学習は、これらの形式言語を用いて、個々の事例(以下、インスタンス)への適合性を評価しながら概念獲得を試みる手法です。 例えば、バージョン空間法(候補削除アルゴリズム)[2]は形式言語で記述された個々のインスタンスに矛盾しない概念空間を(最も緩い概念=全てを受け入れる、最も特殊な概念=最初のインスタンス)から始めて、正しいルール(正例)が与えられた場合に、特殊な概念を一般化、誤ったルールが与えられた場合に、緩い概念を特殊化していくことで、両者が近づいていき、概念の学習を行います。

しかし、これらの手法にはインスタンスが自然言語で表現されている場合に、それを形式言語で表現する限界が存在していました[3, 4]。近年、大規模言語モデル(LLM: Large Language Model)の出現により、この分野に大きなブレイクスルーの可能性が生まれています[5, 6, 7, 8, 9]。LLMは優れた言語理解・生成能力を持つため、形式言語による厳密な表現を介さずとも、自然言語での概念獲得が可能になると期待されています。概念の表現を自然言語で直接編集できる柔軟性も、この手法の大きな利点となっています[10]。その結果、これまでは、自然言語からのルール抽出が大変でしたが、そこをLLMに置き換えることで、曖昧な自然言語からのルール獲得を可能になると見込まれます。

[1]やこのブログでの実験はLLMにより応用範囲が拡張されているであろう帰納的学習をテキスト分類で応用してみたものになります。[1]でも述べられていますが、このアプローチの強みは、ブラックボックスの分類結果に対して、大域的な説明を与えられることです[11]。さらにその説明は人間が記述できる言語であるため、一部は人間がレビューしたり編集したりするような Human in the Loopな学習も可能です。例えば[12]は、誤分類インスタンスについて人間のフィードバックを与えることでルールライブラリを改善していき、倫理課題を含むいくつかの課題でパフォーマンスを向上させています。

方法

今回用いるデータはBig Patent データセット[13]で、特許文書の要約テキストから、その特許がどの分野であるか分類するタスクを採用しています。 訓練データは1000件(一部10000件も実験)、評価データは5000件使用します。

分類者、修正者、圧縮者の3つのLLMエージェントを設定し、以下のサイクルで分類ルールを更新していきます。 なお、分類ルールの初期値はクラスタイトルのみを与えた空のルールにしています。

  • 分類者: 与えられた分類ルールに基づき、与えられたインスタンスの分類を行う。(図2 ①)
  • 修正者: 分類者が間違えたサンプルについて、間違えた結果と判断理由を与えられたら、分類ルールの修正を行います[8]。(図2 ②)
  • 圧縮者: 分類ルールの圧縮を行います。(図2 ③) なお、モデルはLlama 3.1 70Bを用いています。

図2 本手法の全体像

分類者

分類者には以下のプロンプトを与えます(図2 ①)。載せているプロンプトは日本語訳したものです(以下同様)。

### システム
以下の文章を読み、下記に示す9つのクラスの中から最も適切な分野クラスに分類してください。各クラスにはタイトルと、分類のための補足的な手がかりとして3〜10行程度の説明が付いています。
#### 分類ルール
${ここに分類ルールを挿入}

### ユーザー
#### 文章
${ここに訓練インスタンスのテキストを挿入}

#### 出力形式
あなたの回答は以下の形式で書いてください。
{"Number":"(0から8までの数字)","Reason":"(理由)"}
それでは、ステップバイステップで考えていきましょう。

分類ルールとサンプルがインプットで与えられ、分類者には以下のようなアウトプットを期待します。

{"回答":"5", "理由":"XXXX"}

Chain of thoughtプロンプトで理由を出力させてから回答と理由を生成させることで、理由にChain of thoughtの要約内容が入ることを期待しています。

修正者

修正者には以下のプロンプトを与えます。(図2 ②)

あなたは分類の手がかりを改善することを任務とするAIアシスタントです。
各クラスにはタイトルがあり、分類のための補足的な手がかりが3行から約10行あります。

#### 分類ルール
${ここに分類ルールを挿入}


### ユーザー

1. 分類対象テキスト:
${ここに訓練インスタンスのテキストを挿入}

2. 現在の分類:
   ラベル:${ここに分類者の出力のうち分類結果を挿入}
   理由:${ここに分類者の出力のうち理由を挿入}

3. 正しい分類:
   ラベル:${ここに訓練インスタンスの正解を挿入}

あなたの課題は、900文字以内の制限内で正しい分類を確実にするために、「分野クラス」の手がかりを修正することです。

以下のガイドラインに従ってください:
 - 既存の9つのクラスの「タイトル」は変更せず、同じ形式を維持してください。
 - 必要に応じて、手がかりの追加、削除、修正が可能です。
 - さまざまな例に適用できるよう、手がかりは一般的な方法で記述してください。
 - 重複を避け、明確でシンプルで理解しやすい表現を目指してください。

変更された部分と変更されていない部分の両方を含む「分野クラス」の修正版を提供してください。修正されたことを示す必要はありません。

#### 出力形式
回答は以下の形式で提供してください。

0. タイトル:
  - 手がかり
  - 手がかり
  - 手がかり

分類者が誤ったサンプルの文章、分類者の誤答、分類者の判断理由をインプットとして与え、改善者には改善された分類ルールを含む出力を期待します。

圧縮者

出力からルール部分を抽出し、圧縮者に渡します。 圧縮者には以下のプロンプトを与えます。

### システム
あなたは分類のヒントを改善するAIアシスタントです。
各クラスにはタイトルがあり、分類のための補足的なヒントが3行から約10行付いています。
#### 分類ルール
${ここに改善者が編集した分類ルールを挿入}

あなたの課題は、「フィールドクラス」の説明を900語以内で正しく分類されるように修正することです。

以下のガイドラインに従ってください:
- 既存の9つのクラスタイトルは変更せず、同じ形式を維持してください。
- より有用で読みやすく、洗練された内容にするために、説明を必要に応じて修正してください。
- 様々な例に適用できるよう、説明は一般的な方法で記述してください。
- 冗長性を避け、明確でシンプルで理解しやすい内容を目指してください。
- 各フィールドクラスが明確な焦点、重要な側面、典型的な活動を持つようにしてください。
- 冗長性を排除:繰り返しの情報を削除し、類似した要点をまとめてください。
- 修正版が900語以内に収まるようにしてください。

「分類ルール」の修正版を、変更された部分と変更されていない部分の両方を含めて提供してください。修正されたことを示す必要はありません。

#### 出力形式
回答は以下の形式で提供してください。

0. タイトル
 - 手がかり
 - 手がかり
 - 手がかり

修正者者のプロンプトの字数制限の記載がほとんど機能せず、分類ルールが際限なく膨張していくので、圧縮者を追加しています。(図1 ③)(さらにアウトプットトークンサイズを1024トークンとしているため、際限なく膨張することはありません。)

圧縮者の出力から分類ルール部分を抽出します。 このルールを分類者に与えて、次の訓練インスタンスの分類を行なってもらいます。

なお、分類ルールは次のyamlのような形式で記述します。

0. クラスタイトル
 - 手がかり
 - 手がかり

その他

なお、修正者と圧縮者によるルールの編集では、まれに破壊的な編集が行われます。繰り返し編集になるため、どこかしらで破壊的な編集が行われ、また、一度破壊的な編集が行われると、立て直しが不可能になります。 そこで、圧縮者が修正した後の分類ルールが次のような場合は編集を棄却します。(図2 ④)

  • 修正者の編集前の分類ルールとのレーベンシュタイン距離が800超
  • ルールの記述形式のバリデーションが失敗
  • 分類クラス名が編集されている
  • (正解済サンプル5つにおいて、更新後の正解率>=更新前の正解率) なお、正解済サンプル5つは、文書ベクトル空間[14]において、修正箇所とのコサイン距離が小さい判断理由を持つ上位5サンプルを用いています。

また、修正者にバッチで誤りサンプルを与える場合、全然違うサンプルを与えても、それぞれ別々の修正が行われるだけと予想できます。そこで、ある程度誤りサンプルをストックし、一定数を超えたら、分類理由テキストをクラスタリングし、似たサンプルをセット(クラスターのメンバー数が多い場合にはバッチサイズに分割)にして修正者に与えていました。 クラスタリングはBERTopic[15]を参考に、文書ベクトル化(e5) → UMAPで次元圧縮 → HDBSCANで密度ベースクラスタリングの流れを採用しました。

ベースライン

クラスタイトルのみを分類ルールとして与える場合に加え、他の伝統的なルール抽出手法とも比較してみます。

  1. TF-IDF(c-TF-IDF)による重要単語[15]

  2. アソシエーションルール[16]

1はTF-IDFをクラスタリングされた文書に行うことで、各クラスターの代表的な単語の抽出を目的とするものです。これをクラス分類結果に用います。上位55単語を取得しています。 2は文章に出現する単語(名詞と形容詞)とクラスラベルを合わせてシークエンスを作成し、アソシエーションルールマイニングを行います。抽出されたルールのうちクラスラベルを含むもので信頼度が高い順に55個取得しています。アルゴリズムはFP-growthを使用しました。

それぞれ、訓練データ1000件から抽出した重要単語をLlama 3.1 70Bにより、センテンスに変換します。(解釈性を保持し、本手法と条件を揃えるためです。) ただ、本手法は最大1000件の訓練データで分類ルールを作成し、200件のスライディングウィンドウでの正解率が最大のルールを取得しています。その結果、約300サンプルまでの分類ルールを用いているため、若干不利かもしれません。

与えられるのキーワードは、特許分類システム内で特許を特定のカテゴリーに分類するための指標として機能します。これらのキーワードに基づき、各カテゴリーに属する特許の種類を説明し、分類基準を説明してください。

#### 制約事項
- キーワードを省略しないでください。分類ルールの完全版を提供してください。
- 既存の9つのクラスの「タイトル」は変更せず、同じ形式を維持してください。
- 各クラスには最低3行から約10行程度の補足的な分類の手がかりを含める必要があります。
- 様々な例に適用できるよう、手がかりは一般的な方法で記述してください。
- 各分野のクラスが明確な焦点、重要な側面、典型的な活動を持つことを目指してください。
- 改訂版は900トークン以内に収めてください。

#### 出力形式
回答は以下の構造に従ってください:
0. タイトル:
 - 手がかり
 - 手がかり
 - 手がかり

#### タイトルとキーワード
{各クラスそれぞれの、タイトルとキーワード}

あとは、関連手法[5]と比較しようと思ったのですが、以下のようにベースラインに惨敗して、心が折れてしまいました笑

結果

分類精度(全体)

クラスタイトルのみを分類ルールとして与えた場合、本手法で出力した分類ルール、ベースラインとしてc-TF-IDFとアソシエーションルールで出力した分類ルールをそれぞれ分類者(GPT-o4-mini)に与え、評価データでの分類精度(正解率とMacro平均F1値)を測定しました。

手法 正解率 F1値
クラスタイトルのみ 0.356 0.310
本手法 0.382 0.330
c-TF-IDF 0.429 0.379
アソシエーションルール 0.441 0.325

クラスタイトルのみを与えた場合でもLLMは事前に学習した知識でもある程度の分類ができています(事前学習データ内でリークしている可能性も否定できません)。 それと比較して、本手法では正解率とF1値が少し向上しています。 しかしながら、c-TF-IDFの方が本手法よりも正解率、F1値共に優れており、アソシエーションルールも正解率で本手法に大きな差をつけています。 ちなみに、Bi-LSTM(教師あり学習)のF1値は0.78程度[17]のようですので、(ゼロショットの)LLMの分類がそもそも精度が低いです。

次にクラス別のF1値を見てみます。

分類精度(クラス別)

クラス クラスタイトルのみ 本手法 c-TF-IDF アソシエーションルール クラス比率
0. Human necessities 0.428 0.635 0.629 0.620 0.086
1. Performing operations 0.182 0.038 0.346 0.351 0.148
2. Chemistry 0.551 0.572 0.549 0.587 0.164
3. Textiles 0.271 0.272 0.301 0.380 0.025
4. Fixed constructions 0.302 0.337 0.356 0.355 0.044
5. Mechanical engineering 0.313 0.307 0.363 0.382 0.174
6. Physics 0.129 0.180 0.195 0.227 0.024
7. Electricity 0.585 0.576 0.624 0.610 0.274
8. General 0.025 0.053 0.049 0.063 0.060

本手法はクラス1のF1値が非常に悪く、これが全体の精度を大きく下げていました。 おそらく、クラス1に誤ったルールが残ってしまっているのでしょう。ただ、それ以外のクラスでもベースライン手法と比較して大きく精度が高いということもなく、微妙な結果となりました。

ちなみに、本手法の0. Human necessitiesのF1値が比較的良い点については、LLMを用いた分類ルールの改善(修正者)でポジションバイアスが影響したのではないかと気になります。

アブレーションスタディ

分類者をLlama 3.1 8bに変更し、いくつかの条件を変更して、実験しています。

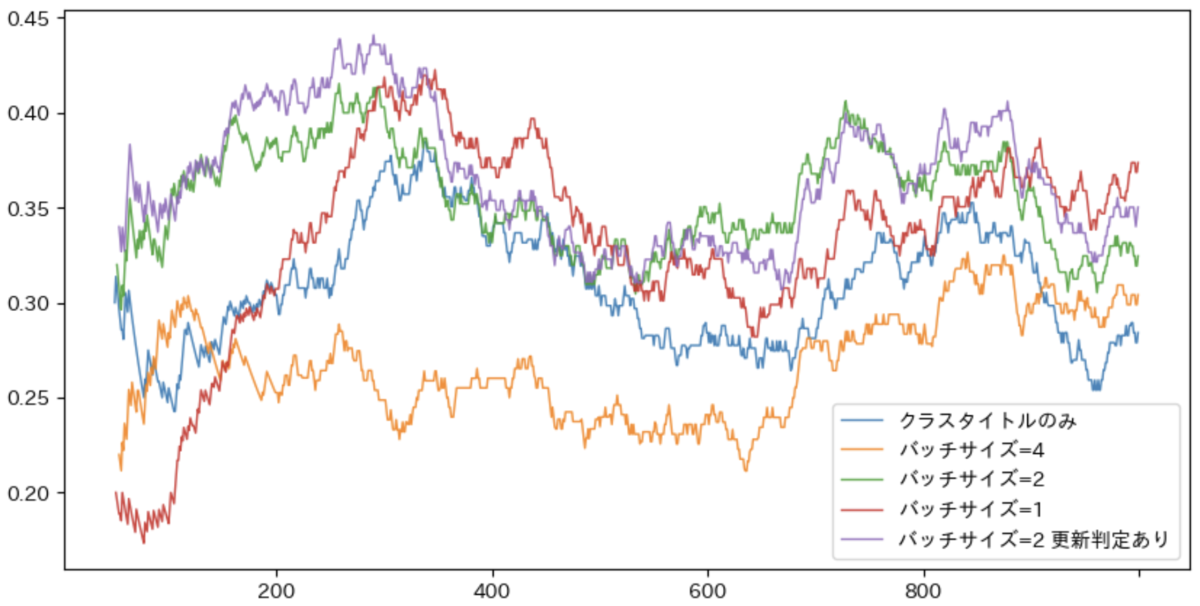
図3 訓練インスタンス学習時のトレース(窓サイズ200件のスライディングウィンドウにおける正解率)

訓練インスタンス1000件の学習過程です。横軸がインスタンス数、縦軸が正解率です。訓練インスタンスが200件をあたりで精度が飽和していることがわかります。

簡単ですが、いくつかの条件を変更して精度を比較しています。厳密にはバリデーションデータで比較した方が良いのですが、1エポックなのと、すぐに精度が頭打ちになっていることから、訓練データでそのまま見ています。

  • クライスタイトルのみ: 分類ルールの修正を行わず、クラスタイトルのみの分類ルールを分類者に与える
  • バッチサイズ=1: 修正者に分類者の誤答を1つ見せる
  • バッチサイズ=2: 修正者に分類者の誤答を2つ見せる
  • バッチサイズ=4: 修正者に分類者の誤答を4つ見せる
  • バッチサイズ=2 更新判定あり: 方法セクション、その他の上段で述べた方法の④の箇所で「正解済サンプル5つにおいて、更新後の正解率>=更新前の正解率」を更新条件として追加した場合

また、改善者に与えるバッチサイズを1,2,4と試した結果、わずかに2が精度が高そうでしたので2を採用しています。さらに、更新判定ありであってもほとんど精度が上がっていないため、こちらは不採用としました。

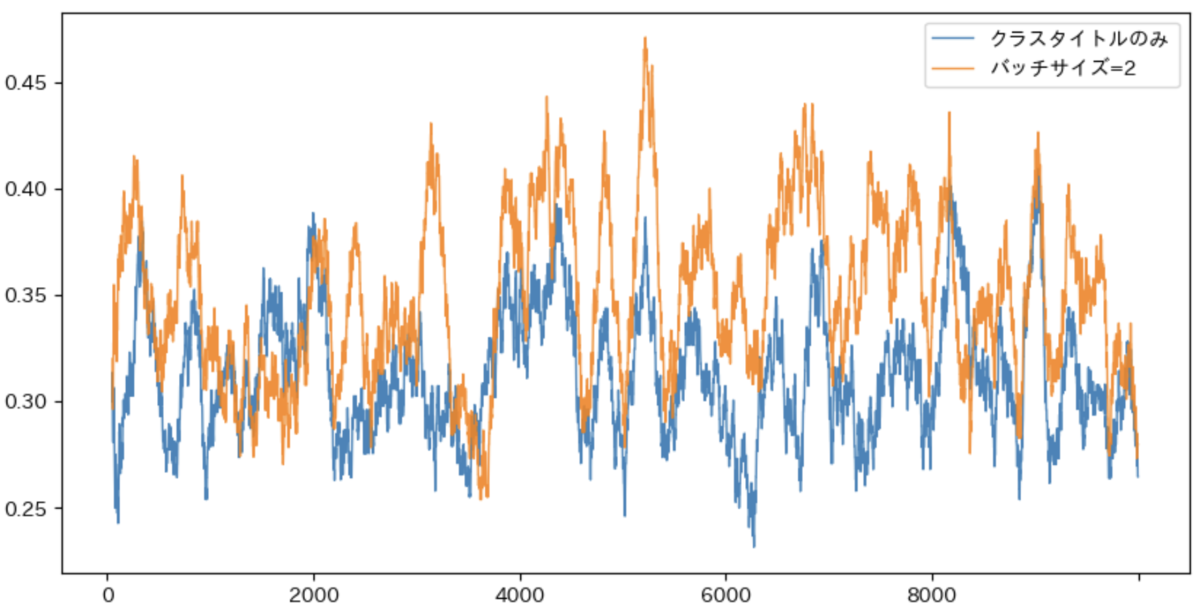
図4 訓練インスタンス学習時のトレース(10000件)

訓練インスタンス10000件の学習過程です。バッチサイズ2の場合とクラスタイトルのみの場合(ルールの修正なし)を実験しています。正解率がすぐに飽和していることがわかります。

ゴールデンスタンダードによる評価

目的がインスタンスからの分類ルールの復元ですので、特許分類(CPC)の分類スキーマ[18]を用いて、CPCタイトルの表すトピックが分類ルールの該当クラスに含まれているかで評価しました。CPCタイトルの粒度はCPCシンボルの/(スラッシュ)以上までとしています。 本当は文献[13]がデータセットを作成したと考えられる2018年時点のスキーマを取得したかったのですが、現行しか見当たらなかったので現行(2024年10月時点)のものを使用しています。

モデルはGPT-4o-miniです。プロンプトは以下の通りです。

### システム
以下のトピック単語は、下記の分類基準に含まれていますか?
分類基準との関連度について回答してください。
スコアは以下の評価基準に従って決定されます。
#### 評価基準
4:完全一致

トピックが分類基準に明示的に表示されている
明確で曖昧さのない整合性がある
除外リストに含まれていない

3:強い関連性

分類基準の直接的な適用または実装
リストされたカテゴリーとの明確なつながり
除外リストに含まれていない

2:間接的な関連性

基準との二次的または派生的なつながり
リストされたカテゴリーをサポートまたは実現する
主に除外されていない

1:関連性なし

基準との意味のある接点がない
除外カテゴリーに該当する
分類の範囲外

#### 分類基準:
${ここに分類ルールのうち該当クラス部分を挿入}

### ユーザー
トピック単語:
${ここにCPC分類スキーマのタイトルを挿入}
出力形式
回答は以下の形式で行ってください。
{"Answer":"(1または4の数字)","Reason":"(理由)"}
では、ステップバイステップで考えてみましょう。
手法 平均得点
本手法 2.00
c-TF-IDF 2.35
アソシエーションルール 2.22

はい😇

ディスカッションとまとめ

[5]で採用しているような、ルールの更新に頻度を反映させるアプローチ[19]が欠けているのは大きな原因なのではないかと考えています。c-tf-idfは単語のクラス内での使用頻度を全体の使用頻度で割って、重要性を算定しています。そして、使用頻度の重要性からルールを構成するための単語を選んでいます。アソシエーションルールも同様に、ある単語がテキストにあった場合のクラス割り当て確率を用いています。 また、CPC分類は膨大で、それをわずか500 語程度の分類ルールで表現すること自体が筋が良くない気がします(実際に精度も微妙)。 LLMを用いた帰納的学習は、ICLRを中心にかなり流行っているので、論文を参考にしながら手法を洗練させていき、再度ベースラインに挑もうと思います。

補足や参考文献

[1] 高野 海斗, 中川 慧, 藤本 悠吾, 大規模言語モデルを用いた金融テキスト二値分類タスクの定義文生成とチューニング手法の提案, 人工知能学会第二種研究会資料, 2024, 2024 巻, FIN-033 号, p. 155-162 https://www.jstage.jst.go.jp/article/jsaisigtwo/2024/FIN-033/2024_155/_article/-char/ja

[2] R. S. Michalski, J. G. Carbonell, and T. M. Mitchell. Machine Learning, Volume 2. Morgan Kaufmann, 1986. https://link.springer.com/book/10.1007/978-3-662-12405-5

[3] H. Alani, S. Kim, D. E. Millard, M. J. Weal, W. Hall, P. H. Lewis, and N. R. Shadbolt. Automatic ontology-based knowledge extraction from Web documents. IEEE Intelligent Systems, 18(1):14–21, 2003. https://oro.open.ac.uk/20051/3/Alani-IEEE-IS-2002.pdf

[4] A. Boufrida and Z. Boufaida, Rule extraction from scientific texts: Evaluation in the specialty of gynecology, Journal of King Saud University - Computer and Information Sciences, vol. 34, no. 4, pp. 1150-1160, 2022. https://www.sciencedirect.com/science/article/pii/S1319157820303736

[5] Zhu, Z., Xue, Y., Chen, X., Zhou, D., Tang, J., Schuurmans, D., & Dai, H. (2024). Large Language Models can Learn Rules. arXiv preprint arXiv:2310.07064. https://arxiv.org/abs/2310.07064

[6] Linlu Qiu, Liwei Jiang, Ximing Lu, Melanie Sclar, Valentina Pyatkin, Chandra Bhagavat- ula, Bailin Wang, Yoon Kim, Yejin Choi, Nouha Dziri, et al. Phenomenal yet puzzling: Testing inductive reasoning capabilities of language models with hypothesis refinement. International Conference on Learning Representations, 2024. https://arxiv.org/abs/2310.08559

[7] R. Wang, E. Zelikman, G. Poesia, Y. Pu, N. Haber, and N. Goodman. Hypothesis Search: Inductive Reasoning with Language Models. In The Twelfth International Conference on Learning Representations, 2024. https://arxiv.org/abs/2309.05660

[8] S. Mirchandani, F. Xia, P. Florence, B. Ichter, D. Driess, M. Gonzalez Arenas, K. Rao, D. Sadigh, and A. Zeng. Large Language Models as General Pattern Machines. In Proceedings of the 7th Annual Conference on Robot Learning (CoRL), 2023. https://arxiv.org/abs/2307.04721

[9] Adrita Barua, Cara Widmer, and Pascal Hitzler. Concept induction using LLMs: a user experiment for assessment. In International Conference on Neural-Symbolic Learning and Reasoning, pages 132-148. Springer, 2024. https://arxiv.org/abs/2404.11875

[10] ただし、自然言語特有の曖昧性により、論理的な厳密性が要求される課題では、従来の形式言語による表現が依然として有効と考えられます。このような場合、形式言語で記述された概念をLLMで編集・拡張していく複合的なアプローチ(例えば[10.1])が有望な解決策となるでしょう。

[10.1] Z. Yang, A. Ishay, and J. Lee. Coupling large language models with logic programming for robust and general reasoning from text. In Findings of the Association for Computational Linguistics: ACL 2023, pages 5186-5219, Toronto, Canada, 2023. https://arxiv.org/abs/2307.07696

[11] 主に説明可能AIの分野での表現です。本手法は、ブラックボックスの分類結果に対して適用できますが、その分類がAIによって与えられたものであるなら、AIの分類結果を事後的に説明できることになり、説明可能AIとして利用できます。大域的な説明というのは、全体としてどのような分類を行っているかの説明です。対して、局所的な説明は個別のデータひとつひとつの分類結果に対して、説明を与えるものです。ちなみに、局所的な説明は、LLMと相性が良く、例えばChain of Thoughtプロンプトで説明を出力できます[11.1, 11.2]。

[11.1] T. Kojima, S. S. Gu, M. Reid, Y. Matsuo, and Y. Iwasawa. Large language models are zero-shot reasoners. In Proceedings of the 36th International Conference on Neural Information Processing Systems, pages 1613:1--1613:15, New Orleans, LA, USA, 2024. Curran Associates Inc. T. Kojima, S. S. Gu, M. Reid, Y. Matsuo, and Y. Iwasawa. Large language models are zero-shot reasoners. arXiv preprint arXiv:2205.11916, 2023. https://arxiv.org/abs/2205.11916

[11.2] Zhang, Z., Zhang, A., Li, M., & Smola, A. (2023). Automatic Chain of Thought Prompting in Large Language Models. In The Eleventh International Conference on Learning Representations. https://arxiv.org/abs/2210.03493

[12] Madaan, A., Tandon, N., Clark, P., & Yang, Y. Memory-assisted prompt editing to improve GPT-3 after deployment. In ACL 2022 Workshop on Commonsense Representation and Reasoning, 2022. https://arxiv.org/abs/2201.06009

[13] Sharma, E., Li, C., & Wang, L. (2019). BIGPATENT: A Large-Scale Dataset for Abstractive and Coherent Summarization. In A. Korhonen, D. Traum, & L. Màrquez (Eds.), Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 2204-2213). Florence, Italy: Association for Computational Linguistics. DOI: 10.18653/v1/P19-1212 huggingface.co

[14] Wang, L., Yang, N., Huang, X., Yang, L., Majumder, R., & Wei, F. (2024). Multilingual E5 Text Embeddings: A Technical Report. arXiv preprint arXiv:2402.05672. huggingface.co

[15] M. Grootendorst. BERTopic: Neural topic modeling with a class-based TF-IDF procedure. arXiv preprint arXiv:2203.05794, 2022. maartengr.github.io

[16] Bing Liu, Wynne Hsu, and Yiming Ma. 1998. Integrating classification and association rule mining. In Proceedings of the Fourth International Conference on Knowledge Discovery and Data Mining (KDD'98). AAAI Press, 80–86. https://cdn.aaai.org/KDD/1998/KDD98-012.pdf

[17] Md Shajalal, Sebastian Denef, Md Rezaul Karim, Alexander Boden, and Gunnar Stevens. Unveiling Black-Boxes: Explainable Deep Learning Models for Patent Classification. In Proceedings of the World Conference on Explainable Artificial Intelligence, pages 457-474, 2023. https://arxiv.org/abs/2310.20478

[18] Bulk Data | Cooperative Patent Classification. Accessed 2024/10/28. Bulk Data | Cooperative Patent Classification

[19] Luis Antonio Galarraga, Christina Teflioudi, Katja Hose, and Fabian Suchanek. AMIE: association rule mining under incomplete evidence in ontological knowledge bases. In Proceedings of the 22nd International Conference on World Wide Web (WWW '13), pages 413-422, 2013. https://resources.mpi-inf.mpg.de/yago-naga/amie/amie.pdf

分類ルールの例

以下に各手法で得た分類ルールを添付いたします(長いです)。こちらはLlama 3.1の出力ですので、利用条件が適用されます。

監査データサイエンス研究の実務応用を考える


こんにちはのろのろでございます。こちらは、会計系Advent Calendarの12月6日分として書いています。記事の内容は監査におけるデータサイエンスの応用研究を調査し、実務的な応用を考えながらまとめたものです。いろいろ手を出しすぎて発散しております。

1 監査データサイエンス

デジタル化が進展し、企業データは財務報告と切り離せない存在になりつつあります。会計監査ではデータサイエンスの手法を応用できる場面が増えてきています。

図1 会計分野におけるデータマイニング研究。括弧内の数値は文献数です。(出典: Amani and Fadlalla. International Journal of Accounting Information Systems 24, p.36.)

図1はAmaniとFadlalla (2017)によって調査された、2017時点までの会計分野ジャーナルやその引用文献のうちデータマイニングを扱っている209の文献の分類を示しています("データマイニング"は"データサイエンス"の少し古い表現でほぼ同義)。"Auditting"は22/209件で監査データサイエンスも会計データサイエンス研究の一つの主要な分野と言えるでしょう。 この記事では監査におけるデータサイエンスに焦点を当てている研究をいくつかピックアップし、いくつかはコードを動かしながら、どのように監査業務に活かしていくかを考えていきます。この記事は包括的な先行研究のレビューではない点はご了承ください。なお、データ分析を用いる監査のことは、Audit analyticsとも呼ばれていますが、"アナリティクス"はビジネス現場での応用の意味合いが強いため、ここでは研究領域として監査(における)データサイエンスと呼びます。

2 財務報告書データへのデータサイエンス

利害関係者のために作成された財務報告書は上場しているのであればインターネットで公開されています。そのため、公開されている財務諸表データを用いた研究は盛んに行われています。

2_1 不正会計予測モデルの概要と実践

まずは不正会計予測モデルについて紹介します。不正会計予測モデルは財務報告書の財務数値やテキスト情報のデータからその財務報告が不正であるかを予測するモデルです。図2はそのイメージを示しています。図の赤の点は不正財務報告書、青の点は正しい財務報告書です。財務報告書の特徴量2つをx軸y軸で図のようにプロットしたとき、赤と青の点をうまく分ける点線をデータから機械学習により推定します。(実際には特徴量は2つ以上あるため高次元でこれが行われます。)

図2 不正会計予測モデルのイメージ図

機械学習モデルにはロジスティック回帰(Dechow et al., 2011)をはじめとして様々なデータサイエンスの予測手法が用いられています。また、日本のデータを使った研究もあります(Song etal., 2016)。ここでは、Baoらによって行われた研究をpythonで実施しながら紹介します(Baoらはmatlabのコードを公開していますが、それをpythonで実装しいくつかの分析例を追加しています)。この研究では不正ラベルを含めたデータセットが公開されており、追試が可能となっています。 github.com

こちらのリポジトリのデータを利用します。

Bao et al., 2020で用いられたデータはニューヨーク証券取引所)、NASDAQ(ナスダック証券取引所)、NYSE American(旧アメリカン証券取引所)等に上場している企業の財務数値であり、このうち、SECのリリースしたAccounting and Auditing Enforcement Releases (AAER)が存在する場合を不正ラベルとしています(AAERの観測と本当に不正があったかは必ずしも整合しているわけではない点は注意が必要です)。 必要なライブラリを準備します。

#python 3.10.12
import lightgbm as lgb # 4.1.0
import pandas as pd # 1.1.3
import numpy as np # 1.26.2
import shap # 0.42.0

from imblearn.ensemble import RUSBoostClassifier # 0.11.0
from sklearn.linear_model import LogisticRegression # 1.3.2
from sklearn.metrics import roc_auc_score,roc_curve,precision_recall_curve,auc,confusion_matrix
import matplotlib.pyplot as plt # 3.7.1

次にデータ(リポジトリ内のdata_FraudDetection_JAR2020.csv)をロードします。

# データの読み込み
filename="PATH_TO_DATASET/data_FraudDetection_JAR2020.csv"
data_FraudDetection_JAR2020=pd.read_csv(filename)

図3 Bao et al., 2020のデータセットの様子

この研究ではRUSBoostというブースティングモデルが用いられ、既存研究のロジスティック回帰やサポートベクターマシンより精度が良いようです。 RUSBoostはAdaboostというアンサンブル法をベースとした手法です。アンサンブル法では学習データからたくさんのサンプルセットを抽出しそれらを順に学習していく中でモデルを改善していくのですが、RUSboostでは、正例(不正な財務データ)の数に等しくなるように、過剰にある負例(正しい財務データ)からサンプリングします。今回のように正例と負例の割合が大きく異なっている場合に有効です。

今回はBao et al. 2020で最もパフォーマンスが良かったRUSBoostに加え、一般的にテーブルデータで高いパフォーマンスを出しやすいLightGBM、論文中で比較対象とされているロジスティック回帰を試してみました。 学習に用いるデータは財務数値の生データをそのまま特徴量として使用しています。(Bao et al., 2020の中で特徴量に比率を用いた場合よりも精度が高いと報告されています。)

roc_auc_list=[] #結果格納用リスト

# LightGBMハイパーパラメータ(チューニングは特にしていません)
param_fixed_lgbm = {
                'boosting_type': 'gbdt',
                'metric': 'binary_logloss',
                'num_iterations': 10000,
                'lambda_l1': 0,
                'lambda_l2': 0,
                'random_seed': 42,
                'objective': 'binary',
                'learning_rate': 0.1,
                'num_leaves': 300,
                'min_data_in_leaf': 50,
                'min_sum_hessian_in_leaf': 20,
                'bagging_fraction': 0.5,
                'bagging_freq': 4,
                'feature_fraction': 0.5
}
# 特徴量カラム(rawデータカラム)
fs_raw_columns_dict={
    'act':'Current Assets, Total',
    'ap':'Account Payable, Trade',
    'at':'Assets, Total',
    'ceq':'Common/Ordinary Equity, Total',
    'che':'Cash and Short-Term Investments',
    'cogs':'Cost of Goods Sold',
    'csho':'Common Shares Outstanding',
    'dlc':'Debt in Current Liabilities, Total',
    'dltis':'Long-Term Debt Issuance',
    'dltt':'Long-Term Debt, Total',
    'dp':'Depreciation and Amortization',
    'ib':'Income Before Extraordinary Items',
    'invt':'Inventories, Total',
    'ivao':'Investment and Advances, Other',
    'ivst':'Short-Term Investments, Total',
    'lct':'Current Liabilities, Total',
    'lt':'Liabilities, Total',
    'ni':'Net Income (Loss)',
    'ppegt':'Property, Plant and Equipment, Total',
    'pstk':'Preferred/Preference Stock (Capital), Total',
    're':'Retained Earnings',
    'rect':'Receivables, Total',
    'sale':'Sales/Turnover (Net)',
    'sstk':'Sale of Common and Preferred Stock',
    'txp':'Income Taxes Payable',
    'txt':'Income Taxes, Total',
    'xint':'Interest and Related Expense, Total',
    'prcc_f':'Price Close, Annual, Fiscal'}

for test_year in range(2003,2014+1):
    rst_dict={'rusboost_auc':None,'lightgbm_auc':None,'logit_auc':None} # 結果格納用dict
    train_end_year=test_year-2 # 学習期間の終点をテスト対象の期間の2年前とする
    data_train=data_FraudDetection_JAR2020.query("fyear <= @train_end_year and fyear >= 1991")
    x_train=data_train[list(fs_raw_columns_dict.keys())] # 特徴量カラムを選択
    y_train=data_train.misstate
    paaer_train_set=set(data_train.p_aaer)
    
    data_test=data_FraudDetection_JAR2020.query("fyear == @test_year")
    x_test=data_test[list(fs_raw_columns_dict.keys())] # 特徴量カラムを選択
    y_test=data_test.misstate
    paaer_test_set=set(data_test.p_aaer)

    mask=y_train.index.isin(paaer_train_set&paaer_test_set) # AAERは連続した年度で観測されるため(遡及するため)評価データと学習データの両方に含まれていた場合には学習データを正常ラベルに置き換える
    y_train.loc[mask]=0

    # RUSboosting
    clf = RUSBoostClassifier(random_state=0,n_estimators=300,learning_rate=0.1,sampling_strategy=1) # 論文著者がハイパーパラメータ探索し最良と思われるものを使用
    clf_fit=clf.fit(x_train, y_train)
    pred_score=clf.predict_proba(x_test)[:,1]
    rst_dict['rusboost_auc']=roc_auc_score(y_test, pred_score)

    # lightgbm
    model_clf_lgbm = lgb.LGBMClassifier(**param_fixed_lgbm)
    model_clf_lgbm.fit(x_train,y_train)
    pred_score_lgbm=model_clf_lgbm.predict_proba(x_test)[:,1]
    rst_dict['lightgbm_auc']=roc_auc_score(y_test, pred_score_lgbm)

    # logit
    lr = LogisticRegression(max_iter=10000)
    lr.fit(x_train, y_train)
    pred_score_lr=lr.predict_proba(x_test)[:, 1]
    rst_dict['logit_auc']=roc_auc_score(y_test, pred_score_lr)
    roc_auc_list.append(rst_dict)

print(pd.DataFrame(roc_auc_list).mean()) # AUCの平均値の表示
    

出力

rusboost_auc    0.697540
lightgbm_auc    0.730373
logit_auc       0.661345

予測は各モデルに実装されている"predict_proba"メソッドを持ちいて0〜1の予測スコアとして出力できます。1に近いほど正例(不正財務報告)である可能性が高いと解釈できます。 予測の精度は評価期間をスライドしながら計算したAUC(偽陽性率(False Positive Rate)を、縦軸に真陽性率(True Positive Rate)をプロットした曲線の曲線下面積で1に近いほど良い)を平均したAUC(時系列におけるクロスバリデーション指標です)で評価しています。

こちらに載っているRUSBoostの平均AUCが0.719なので乱数等の原因で少しずれていますが、ロジスティック回帰よりもAUCが高い点は再現できました。(LightGBMが最もAUCが高い結果となりましたので以降はLightGBMを用います)

後の分析例のためにテストデータを2014年以降として再度LightGBMのモデルを学習します。

test_year=2014
train_end_year=test_year-2 # 学習期間の終点をテスト対象の期間の2年前とする
data_train=data_FraudDetection_JAR2020.query("fyear <= @train_end_year and fyear >= 1991")
x_train=data_train[list(fs_raw_columns_dict.keys())] # 特徴量カラムを選択
y_train=data_train.misstate
paaer_train_set=set(data_train.p_aaer)
data_test=data_FraudDetection_JAR2020.query("fyear >= @test_year")
x_test=data_test[list(fs_raw_columns_dict.keys())] # 特徴量カラムを選択
y_test=data_test.misstate
paaer_test_set=set(data_test.p_aaer)
mask=y_train.index.isin(paaer_train_set&paaer_test_set) # AAERは連続した年度で観測されるため(遡及するため)評価データと学習データの両方に含まれていた場合には学習データを正常ラベルに置き換える
y_train.loc[mask]=0
model_clf_lgbm = lgb.LGBMClassifier(**param_fixed_lgbm)
model_clf_lgbm.fit(x_train,y_train)
pred_score_lgbm=model_clf_lgbm.predict_proba(x_test)[:,1]

2.2 不正会計予測モデルのいくつかの問題

2.2.1 評価指標について

AUCは汎用的な評価指標として良く用いられますが、本来は応用するタスクで求められる指標で評価すべきです。

例として、ある監査法人がクライアントの10%に不正に強い監査人をアサインすると考えます。この状況では、スコア上位10%の企業にどれだけ不正財務データ(正例)が含まれているかが見るべき指標の一つになります。この指標はPrecisionと呼ばれています。

mask=pred_score_lgbm>np.quantile(pred_score_lgbm,0.90) # スコア上位10%以上にフラグを立てる
base_precision=y_test.sum()/len(y_test) # 全体の正例割合
print("base_precision:",base_precision)
lgbm_precision=y_test[mask].sum()/mask.sum()# スコア上位10%の正例割合
print("lgbm_precision:",lgbm_precision)
print("rate:",lgbm_precision/base_precision)# スコア10%に絞ることで正例割合が何倍になるか

出力

base_precision: 0.0007108583614714769
lgbm_precision: 0.003552397868561279
rate: 4.997335701598579

ということでLightGBMのスコア上位10%に絞ることで正例割合を5倍近くまで上げることができました。 一方、取りこぼしの無さを重視する場合には、スコアで絞った中に全体の正例のうちいくつ含まれているかといった指標(真陽性率)で評価します。Recallとも呼ばれています。別のケースでは、例えば、監査契約の受注判断時には機械学習の予測スコアが閾値以下を条件とすることを想定し、例えば、予測スコア0.3以下に絞った場合に正例がどのくらい含まれてしまうかで判断すると良いでしょう。

このように、目的に応じた精度を把握することで、予測スコアにどのくらいの信頼を置いていいかを把握しながら利用していくことができます。

2.2.2 学習データの選択バイアス

学習で用いているデータは1991年〜2008年までの上場企業のデータです。つまり、非上場の財務データにこれを適用しようとすると、平均的な学習データと乖離しています。また、上場企業であっても、2008年以降のデータではそれ以前から経済状況も変わってくるため、平均的に学習データと乖離してしまいます。

このような場合を共変量シフト(Sugiyama et al., 2012)と呼び、ドメイン適応と呼ばれる手法で対応できます。例えば、上の例では非常上企業の財務データや直近の財務データのように適応させたい特徴量データがあれば(不正かどうかの正解ラベルは不要)、重要度重み付き損失を用いて適応させることができます。 LightGBMでは引数"weight"に重要度を渡すことで実施できます。

lgb.LGBMClassifier(**param_fixed_lgbm, weight=importance_weight_array)

この重要度とは適応元の学習データの分布と適応先の学習データの分布の密度比です。適応元の学習データと適応先の学習データの分類をロジスティック回帰モデルに学習させ、その適応先である確率の推定値pを用いて、重要度=(1-p)/pとして代用することもあります。

2.3 不正会計予測モデルの応用

2.3.1 財務諸表全体としてのリスク評価

不正会計予測モデルの出力する予測スコアは監査計画のためのリスク評価や受注判断のためのリスク評価として使用できます。

相対比較をする場合には気にしなくて良いのですが、不正予測スコアそのものを確率として解釈したい場合には、注意が必要です。 不均衡データへの対応としてアップサンプリング/ダウンサンプリングをして正例と負例の割合を変更していると予測スコアが確率とずれてしまう点に注意が必要です(Pozzolo et al., 2015)。こちらの解説がわかりやすいです。

pompom168.hatenablog.com

また、lightGBMなどのアンサンブル法を使っていてもアルゴリズム内のサンプリングに起因しずれてしまうようです。以下のようにscikit-learnのCalibrationCVというライブラリで修正する方法もありますが、筆者の経験ではある程度データがないと綺麗に修正できません。

from sklearn.calibration import calibration_curve,CalibrationDisplay
from sklearn.calibration import CalibratedClassifierCV
lgb_calibrated_model = CalibratedClassifierCV(model_clf_lgbm, method='sigmoid', cv=5)
lgb_calibrated_model.fit(x_train, y_train)

確率予測を行う場合にはダウンサンプリング等を行わずにロジスティック回帰モデルを用いると経験的にずれが生じにくく良いでしょう。

2.3.2 個別アサーションのリスク評価

個別の勘定科目が特徴量に紐づいている場合、不正予測モデルの予測スコアが割り付けられた財務諸表データについて、どの特徴量が決め手となったか(機械学習モデルの判断根拠)を推定することで、個別の勘定科目のリスク評価に役立てることができます。このように判断根拠を推定する方法は説明可能AIという分野で研究が進められています。ここではSHAPという手法で予測値に説明を与えます。SHAPライブラリは他のライブラリへの依存が強いため、使用するpythonのバージョンに注意してください。

import shap 
explainer   = shap.TreeExplainer(model_clf_lgbm)
shap_values = explainer.shap_values(x_train)
ind=3 # 3番目のデータの予測値の説明をウォーターフォール図で示す
shap.plots._waterfall.waterfall_legacy(explainer.expected_value[1], shap_values[1][ind],x_train_rename.iloc[ind,:])

図4 SHAPによる予測スコアの説明

図4は3番目のデータの予測値の説明をウォーターフォール図で示しています(加減算で示せるように予測スコアは対数ロジット変換されています)。 3番目のデータの予測値の対数ロジット値-5.001は、ベースとする平均予測値の対数ロジット値-6.862より1.861多くなっていますが、この主な要因は「Long-term Dept issuarance」(長期の保証債務)や「Price Close, Annual, Fiscal」(会計期間における株価の終値のようです)のように、特徴量の予測値への推定貢献度の和として表すことができます。ただし、必ずしもこれらの特徴量が直接の原因となっているわけではない点(例えば不正が起こりやすい業種の特徴が勘定科目の特徴として観測されている場合がある)には注意が必要です。

さらに、勘定科目が説明可能AIで提示できたとしても、特に不正ラベルを教師データとして学習した不正会計予測モデルの予測スコアは不正リスクに関係するため、監査人は具体的に不正のシナリオを把握する必要があります。その説明可能AIによる特徴量の貢献度だけでなく、判断が類似した教師データを参照することが望ましいです。例えばSHAPによる各特徴量の推定貢献度の相関係数が大きい不正財務データを検索することで、判断根拠の近いデータを参照することができます。その企業を調べることで不正ラベルの原因となった不正事例を把握し、不正リスクを識別するかの判断に活かすことができます。過去の不正についてデータベースを作っていれば検索の手間がかかりません。

2.4 開示レビューへのデータサイエンス

財務数値だけでなく財務報告書そのものに対してのモデルも研究されています。Biesner et al., 2022では財務報告書の段落とチェックリストとのマッチングをsentenceBERTという手法で学習しています。sentenceBERTはtransformerをベースとしたニューラルネットワークの2段階の学習からなり、1つ目はテキストそのものの学習です。直前までの文書から次に続く文の予測や前後の単語からマスキングされた単語を予測するタスクで学習します。2つ目は同じ画像についている複数のキャプション文章の一致(不一致)を学習します。Biesner et al., 2022では2段階目の学習を財務報告書の段落とチェックリストのマッチングとして行います。学習データは財務報告書の段落がチェックリストの内容に該当した場合にフラグをつけるアノテーションを監査法人が行なったもののようです。

図5 財務報告書のテキストとチェックリストのマッチングのイメージ(出典:Biesner, D. , Pielka, M. , Ramamurthy, R. , Dilmaghani,T. , Kliem, B. , Loitz, R., Sifa, R. (2022). Zero-Shot Text Matching for Automated Auditing using Sentence Transformers. 21st IEEE International Conference on Machine Learning and Applications, p.1638.)

監査人がチェックリストをもとに財務報告書のレビューを行う場合、チェックリストに関連する箇所を財務報告書から探し、それがチェックリストの内容に準拠しているか確認します。このうちチェックリストに関連する箇所を財務報告書から探す過程はBiesner et al., 2022の手法で自動化することで時間短縮ができると思います。 財務報告書からの情報抽出の研究は、他にもKPI情報抽出(Ramamurthy et al., 2021)やリスク要素の抽出(Tsai and Wang 2017)等があります。これらは自然言語処理分野の知識抽出(固有表現抽出)タスクを財務報告書に応用しています。自然言語処理の研究はchatGPTをはじめとした大規模言語モデルの登場により大きくパフォーマンスを向上させているため、今後この分野のパフォーマンスの向上が期待できます。

3 トランザクションデータへのデータサイエンス

トランザクションデータは企業の経済取引や業務の記録をイベント単位で記録しているデータです。財務報告書は会計に関連するトランザクションを集計して作成されるため、トランザクションデータは財務報告書よりも時間的にも科目的にも細かい情報を持っています。トランザクションデータは膨大になるので監査人が目視でレビューするのは大変です。 トランザクションデータに対する不正検知や異常検知は盛んに研究されてきました。正常トランザクションデータの入力パターンを学習しておくことで、企業が不正なトランザクションを挿入した時に、学習した正常トランザクションのパターンからの異常として検知することが狙っています。例えば、トランザクションデータの異常検知を目的として、クラスタリング(例えばJans et al., 2010)や自己組織化マップを用いた研究(例えばArgyrou 2012)や、プロセスマイニングの手法を転用したもの(例えばEvermann et al., 2017)もあります。近年はニューラルネットワークのパフォーマンス向上により、トランザクションデータの異常検知分野ではAuto-encoder(VAE、GANなどの類似手法含む)の研究がたくさんでてきます。ここではSchreyer et al., 2017を紹介します。

3.1 オートエンコーダを用いたトランザクションデータの異常検知

Schreyer et al., 2017もソースコード(python)とデータセットが公開されており、追試が可能となっています。

github.com

図6 オートエンコーダによるトランザクションデータの異常検知(出典:Schreyer, M., Sattarov, T., Borth, D., Dengel, A.R., & Reimer, B. (2017). Detection of Anomalies in Large Scale Accounting Data using Deep Autoencoder Networks. ArXiv, abs/1709.05254.)

オートエンコーダを用いたトランザクションデータの異常検知は図6のように行われます。図の丸いノード群はニューラルネットワークを示します。トランザクションデータをニューラルネットワークの入力とし、また、出力もトランザクションデータに近づけるように学習します。オートエンコーダのニューラルネットワークの中間層は入力層よりもノードの数が少ないため、入力された情報を一度圧縮し出力を再構成します。この圧縮の過程で入力されるトランザクションデータの潜在的なパターンを学習します。異常判定対象のデータについて、正常データで学習したオートエンコーダで再構成したときの誤差が大きいほど異常度が高いとしています。

3.2 トランザクションデータの異常検知の問題点

トランザクションデータの異常検知で問題になるのが、データ量です。大企業でもない限り、1企業のデータではトランザクションデータの入力規則を十分に学習するには不十分な場合が多いです。複数の企業のデータを使いたいところですが、内部監査で他社のデータを使用することは通常できず、外部監査でも監査人がクライアントのデータをそのまま一緒に使うことは情報管理の観点から問題があります。そこであらかじめトランザクションデータの表現を学習しておいて、下流の監査タスクの精度を高めるアプローチが提案されています(Schreyer et al., 2021)。Schreyer et al., 2021では、SimCLRという自己教師あり学習(オートエンコーダによる学習と目的は同じ)でトランザクションデータの入力規則を事前学習することで、後続する個別の監査タスクの精度を向上させます。事前学習と個別の監査タスクの学習の2段階に分けることで、事前学習に監査対象外のものも含めたトランザクションデータ(例えば監査対象年度より前のトランザクションデータ)を用いてデータ量を補うことができます。

外部監査において、監査人がクライアントのデータをそのまま一緒に使うことは情報管理の観点から難しいのですが、クライアントのデータの秘匿性を維持しながら機械学習モデルを訓練させる手法が研究されています。学習データを異なるサーバーに分散して保存しながら一つの機械学習モデルを学習させる連合学習では、機械学習モデルの学習のための勾配にノイズを加えることで、それぞれの学習データの秘匿性を維持しています。Schreyer et al., 2022はそのフレームワークの一つであるDP-SGDを会計トランザクションデータに応用しています。

3.3 トランザクションデータの異常検知の応用

3.3.1 業務フローや内部統制の理解への応用

プロセスマイニングの手法はトランザクションデータの異常検知に転用されていますが、プロセスマイニングの手法自体を監査で使用することができます。 プロセスマイニングは業務やシステムのログの前後関係からプロセスの構造を抽出する手法です。 例えば、次のようなトランザクションを記録したテーブルがあるとします。

図8 会計トランザクションデータの例

このトランザクションデータは受注トリガーで製品を仕入販売する企業をイメージして作成しています。"case_id"カラムは一つの受注契約にいくつかのトランザクションデータ(仕入、販売、買掛金支払、売掛金回収)を紐づけています。プロセスマイニングはこれらのトランザクションデータの入力規則を視覚的に把握する手法です。入力規則を数え上げる手法はpythonライブラリ"pm4py"を用いて実施できます。

ここでは図8の会計トランザクションデータが"example_log_df"の変数に格納されています。これをpm4pyのフォーマットにすることで可視化することができます。この際に仕分のパターンを横に繋て一つのカラムにまとめています。

import pm4py
import pandas
import datetime as dt

# トランザクションデータセットを作成
example_log=[
    {'case_id':1,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/1/3 10:00:00'},
    {'case_id':1,'d_account':'買掛金','c_account':'当座預金','amount':100,'ts':'2022/2/20 9:30:00'},
    {'case_id':1,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/1/21 11:00:00'},
    {'case_id':1,'d_account':'当座預金','c_account':'売掛金','amount':500,'ts':'2022/2/18 9:00:00'},
    {'case_id':3,'d_account':'仕入','c_account':'買掛金','amount':500,'ts':'2022/1/5 10:00:00'},
    {'case_id':3,'d_account':'買掛金','c_account':'当座預金','amount':500,'ts':'2022/2/20 9:30:00'},
    {'case_id':3,'d_account':'売掛金','c_account':'売上','amount':800,'ts':'2022/2/23 11:00:00'},
    {'case_id':3,'d_account':'当座預金','c_account':'売掛金','amount':800,'ts':'2022/3/20 9:00:00'},
    {'case_id':4,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/1/17 10:00:00'},
    {'case_id':4,'d_account':'買掛金','c_account':'当座預金','amount':100,'ts':'2022/2/20 9:30:00'},
    {'case_id':4,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/2/23 11:00:00'},
    {'case_id':4,'d_account':'当座預金','c_account':'売掛金','amount':500,'ts':'2022/3/9 9:00:00'},
    {'case_id':5,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/2/3 10:00:00'},
    {'case_id':5,'d_account':'買掛金','c_account':'当座預金','amount':100,'ts':'2022/3/20 9:30:00'},
    {'case_id':5,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/2/13 11:00:00'},
    {'case_id':5,'d_account':'当座預金','c_account':'売掛金','amount':500,'ts':'2022/3/18 9:00:00'},
    {'case_id':2,'d_account':'仕入','c_account':'買掛金','amount':200,'ts':'2022/1/23 10:00:00'},
    {'case_id':2,'d_account':'買掛金','c_account':'当座預金','amount':200,'ts':'2022/2/2 9:30:00'},
    {'case_id':2,'d_account':'商品','c_account':'仕入','amount':200,'ts':'2022/1/31 12:59:00'},
    {'case_id':2,'d_account':'仕入','c_account':'商品','amount':200,'ts':'2022/2/1 0:00:00'},
    {'case_id':2,'d_account':'売掛金','c_account':'売上','amount':600,'ts':'2022/2/4 11:00:00'},
    {'case_id':2,'d_account':'当座預金','c_account':'売掛金','amount':600,'ts':'2022/2/12 9:00:00'},
    {'case_id':9,'d_account':'仕入','c_account':'当座預金','amount':100,'ts':'2022/3/3 10:00:00'},# Cに100支払い
    {'case_id':9,'d_account':'当座預金','c_account':'売上','amount':500,'ts':'2022/3/21 11:00:00'},# Aから500収入
    {'case_id':12,'d_account':'仕入','c_account':'当座預金','amount':500,'ts':'2022/3/3 10:00:00'},# Cに500支払い
    {'case_id':12,'d_account':'当座預金','c_account':'売上','amount':800,'ts':'2022/3/21 11:00:00'},# Aから800収入
    {'case_id':10,'d_account':'出資金','c_account':'当座預金','amount':700,'ts':'2022/3/30 9:00:00'},# Bに投資
    {'case_id':7,'d_account':'出資金','c_account':'当座預金','amount':300,'ts':'2022/1/4 9:00:00'},# Bに投資
    {'case_id':6,'d_account':'仕入','c_account':'当座預金','amount':100,'ts':'2022/1/3 10:00:00'},
    {'case_id':6,'d_account':'当座預金','c_account':'売上','amount':500,'ts':'2022/1/7 11:00:00'},
    {'case_id':7,'d_account':'仕入','c_account':'当座預金','amount':100,'ts':'2022/1/9 10:00:00'},
    {'case_id':7,'d_account':'当座預金','c_account':'売上','amount':500,'ts':'2022/1/13 11:00:00'},
    {'case_id':11,'d_account':'仕入','c_account':'当座預金','amount':100,'ts':'2022/1/22 10:00:00'},
    {'case_id':11,'d_account':'当座預金','c_account':'売上','amount':500,'ts':'2022/1/27 11:00:00'},
    {'case_id':8,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/1/23 10:00:00'},
    {'case_id':8,'d_account':'買掛金','c_account':'当座預金','amount':100,'ts':'2022/2/2 9:30:00'},
    {'case_id':8,'d_account':'商品','c_account':'仕入','amount':100,'ts':'2022/1/31 12:59:00'},
    {'case_id':8,'d_account':'仕入','c_account':'商品','amount':100,'ts':'2022/2/1 0:00:00'},
    {'case_id':8,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/2/4 11:00:00'},
    {'case_id':8,'d_account':'当座預金','c_account':'売掛金','amount':500,'ts':'2022/2/12 9:00:00'},
    {'case_id':12,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/3/1 10:00:00'},
    {'case_id':12,'d_account':'買掛金','c_account':'当座預金','amount':100,'ts':'2022/3/20 9:30:00'},
    {'case_id':12,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/3/23 11:00:00'},
    {'case_id':13,'d_account':'仕入','c_account':'買掛金','amount':100,'ts':'2022/3/14 10:00:00'},
    {'case_id':13,'d_account':'売掛金','c_account':'売上','amount':500,'ts':'2022/3/25 11:00:00'},
    {'case_id':14,'d_account':'仕入','c_account':'買掛金','amount':300,'ts':'2022/3/22 10:00:00'},
    {'case_id':14,'d_account':'売掛金','c_account':'売上','amount':600,'ts':'2022/3/28 11:00:00'}
]
example_log_df=pd.DataFrame(example_log) # データフレームとして格納
example_log_df['timestamp']=pd.to_datetime(example_log_df.ts) # 時間情報をタイムスタンプ型に変換
example_log_df['account']=example_log_df['d_account']+'/'+example_log_df['c_account'] # 仕分パターンを定義
example_log_df_f = pm4py.format_dataframe(example_log_df, case_id='case_id', activity_key='account', timestamp_key='timestamp') # pm4pyフォーマットに変換

"pm4py"ライブラリではいくつかの手法で可視化できますが、今回はDirectly Follows Graphというパターンの数え上げの手法を試してみます。細かいパターンがある場合にはメジャーなパターンのみを学習させる方法が良いでしょう。 内部統制の監査では、業務プロセスの把握をしますが、業務プロセスのログからパターンを見つけておくと、どのような業務フローがあるかの整理に役立ちます(担当者のヒアリングでは把握漏れが発生する場合もあります)。ただし、この方法を効果的に使うためには、ある案件に紐づく会計処理などのアクションを識別するための案件キーが必要であり、これを管理している会社はかなり少ないのではないかと思います。案件キーがない場合でも、商品ごとや取引先ごとにいくつかの処理がある場合には、商品IDや顧客IDをキーにすることでフローを可視化することが可能になります。

dfg, start_activities, end_activities = pm4py.discover_dfg(example_log_df_f)
pm4py.view_dfg(dfg, start_activities, end_activities)

図9 DFG法によるプロセスの可視化

3.3.2 リスク評価への応用

トランザクションデータへの異常検知は財務報告に関連する取引の全量に対して行うことができ、会計監査におけるリスク評価として導入されつつあります。

例えば、トランザクションデータの入力規則をオートエンコーダに学習させ、オートエンコーダの再構成誤差(異常スコア)が大きい異常なデータについて監査上のリスクの候補にする応用ができます。機械学習の結果を人間が解釈するため、単なる異常スコアだけでなく、説明可能AI等の手法で解釈性を与えると良いでしょう。トランザクションデータは企業活動を取引レベルで記録していることが多く、細かいレベルでのリスク評価が可能になります。また、トランザクションデータに記録されているイベントが財務報告に反映されているかという点で網羅性の検討が可能になります。

3.3.3 仕訳テストへの応用

トランザクションデータへの異常検知の研究は不正なトランザクションの挿入を検知することを主な目的としています。そのため、会計監査のプロセスの一つである仕訳テストが自然な応用先です。仕訳テストは不正な仕訳を検知することを目的にしているため、検出した仕訳は不正対応が求められ監査人のリソースを多く消費します。 そのため、仕訳テストへの応用の際には高い精度が求められます。 トランザクションデータの異常検知モデルを導入する際には監査品質管理として、過去の不正発生時のデータとそうでないデータに対して実施し、精度評価することが重要です。評価指標としては2.2.1で紹介したPrecisionとRecallが適しています。 (現行の監査の基準に例示されているルールベースの仕訳テストで実施した場合の精度を超える場合には導入を検討しても良いと思いますが、ルールベースの仕訳テストの精度が評価されている報告は見たことがありません)

3.3.4 詳細テストや内部統制の運用評価手続への応用

詳細テストは精査(全件調査)か試査(一部を調査して母集団に対する結論を統計的に推論)のアプローチがありますが、トランザクションデータの異常検知モデルで精査を行うことはできません。オートエンコーダをはじめとする機械学習モデルの出力はあくまで仮説の出力であるため、そのデータが誤りであるかは別途検証(証憑突合など)が必要になるからです(精査へのデータサイエンスの応用は証憑突合の自動化などの領域になります)。ここでは試査への応用を考えてみます。

試査は特定項目抽出による試査とサンプリングによる試査があります。トランザクションデータの異常検知による異常判定を特定項目抽出として試査対象とすることができます。ただし、特定項目抽出による試査では異常と判定されていない残余母集団について結局のところ証票突合などの実証手続を検討する必要が生じるため、監査の効率は上がりません(品質は向上します)。ちなみに、PCAOB AS 2401では、重要で異常な取引についてその取引の合理性等を検討するよう規定されており、異常検知されたデータについてはこれに該当するか検討が必要になりそうです。

次に、サンプリングへの応用についてですが、ここでは統計的サンプリングへの応用を考えます。統計的サンプリングは抽出したサンプルを検証し、その結果から母集団の虚偽表示額や内部統制の逸脱数を統計的に推論する方法です。この際のサンプルサイズが監査の効率に大きく影響しますが、例えば内部統制の逸脱の評価では、母集団の逸脱数が許容される逸脱率(例えば9%)と等しいという帰無仮説を、検証したサンプルの標本逸脱数が0件のときに棄却できるように設計されています。標本調査のサンプルサイズは推定したい変数と相関する補助変数を用いることで推定値の誤差を維持しつつサンプルサイズを小さくすることができます。会計監査では虚偽表示リスク(内部統制では内部統制からの逸脱)と関係するスコアリングモデルやクラスタリングができれば、それを補助変数(クラスタリングの場合はカテゴリ変数)として母集団の虚偽表示額(逸脱率)の推定を少ないサンプルサイズで行うことができます。

ここで、母集団全体に対して異常検知モデルで異常スコアを算定したものを補助変数として用いるには、異常検知モデルによる異常度はあくまで異常度であることから潜在虚偽表示リスクとの相関が高いかどうか調べなければなりません。また、クラスタリングにでは、クラスターごとに虚偽表示率がある程度等しいというかどうかが重要です。オートエンコーダによるトランザクションデータの入力規則学習を監査サンプリングへの応用しようとしている研究があります(Schreyer et al., 2020)

図10 オートエンコーダによる監査サンプリング出発点のイメージ図(出典:Schreyer, M., Sattarov, T., Gierbl, A.,Reimer ,B. and Borth, D. (2020). Proceedings of the First ACM International Conference on AI in Finance (45). p.5)

この研究ではオートエンコーダの派生手法であるVQ-VAEの圧縮空間(潜在埋め込み空間)として監査サンプリングの出発点を提供しています。これらの埋め込み空間で近いデータ同士の虚偽表示率が等しいという前提を置くことができれば、監査での応用が期待できそうです。なお、この論文では、統計的サンプリングを意識した評価、すなわち無作為サンプリングに対しての比較やk-meansクラスタリングやルールベースのクラス分けとの比較がされていないため、統計的サンプリングの実用にはこれらの評価が必要です。

現行の監査の基準においても層化抽出や比例抽出などは規定されているものの(PASOB AS 2315)、その際に監査サンプリングで帰無仮説の逸脱率と信頼度を満たすサンプルサイズが少なくて済むかどうかまでわかって初めて単純無作為サンプリングを代替することができます。標本抽出法については理論があるものの、この辺りを監査に落とし込んでいる研究は少なく、データサイエンスの導入にあたりしっかりと整理する必要があると考えています。この場合の評価指標としては、デザイン効果や有効標本サイズ(Kish 1965)で評価するとよいでしょう。

4 その他のデータサイエンスの応用がしやすい領域

個別アサーションの見積りや分析的手続ではデータサイエンスの応用がしやすいです。例えば、引当金の見積額に対する監査人独自の評価範囲に機械学習モデルを利用できます。これらは予測タスクとして研究されていますが、監査用途を強く意識した研究はあまり多くなく、各論になってしまうのでここでは省略します。また、OCR、証憑レビューの自動化、文書検索、衛星データのように監査手段としての技術の応用ができますが、こちらも手段そのものが研究対象となっていますので省略します。

5 まとめ

監査へのデータ分析の適用可能な領域は多く、データサイエンスの様々な手法が活かされています。最近のデータサイエンス領域ではテキストや画像の表現学習のパフォーマンス向上が著しく、特にテキストデータが多く存在する会計データでもパフォーマンス改善が期待できます。一方で、会計データの特徴や監査固有の実務的な問題設定にデータサイエンス分野の手法でアプローチしていくような研究はまだまだ少なく、実用にはもう何段階か研究を進める必要がある印象です。データサイエンスを活かした研究が監査品質と効率性の向上に貢献することを期待しています。

参考文献

[1] Amani, F. A. Amani, Fadlalla, A. M. (2017). Data mining applications in accounting: A review of the literature and organizing framework. International Journal of Accounting Information Systems 24, pp. 32-58.

[2] Dechow, P. M., W. Ge, C. R. Larson, and R. G. Sloan. (2011). Predicting material accounting misstatements. Contemporary Accounting Research 28: pp. 17-82.

[3] Song, M., N. Oshiro, and Shuto, A. (2016). Predicting Accounting Fraud: Evidence from Japan. The Japanese Accounting Review 6: pp. 17-63.

[4] Bao, Y., Ke, B., Li, B., Yu, Y.J., and Zhang, J., (2020). Detecting accounting fraud in publicly traded u.s. Firms using a machine learning approach. Journal of Accounting Research 58, pp. 199–235.

[5] Sugiyama, M., Suzuki, T., and Kanamori, T. (2012). Density ratio estimation in machine learning. Cambridge, UK: Cambridge University Press.

[6] Pozzolo, A. D. , Caelen, O. , Johnson, R. A. and Bontempi, G. (2015). Calibrating Probability with Undersampling for Unbalanced Classification, 2015 IEEE Symposium Series on Computational Intelligence, Cape Town, South Africa, pp. 159-166.

[7] Biesner, D. , Pielka, M. , Ramamurthy, R. , Dilmaghani,T. , Kliem, B. , Loitz, R., and Sifa, R. (2022). Zero-Shot Text Matching for Automated Auditing using Sentence Transformers. 21st IEEE International Conference on Machine Learning and Applications, pp. 1637-1642.

[8] Ramamurthy, R., Pielka, M., Stenzel, R., Bauckhage, C., Sifa, R., Khameneh, T. M., Warning, U., Kliem, .B, and Loitz, R. (2021) ALiBERT: improved automated list inspection (ALI) with BERT. Proceedings of the 21st ACM Symposium on Document Engineering (20), pp. 1–4.

[9] Tsai, M. F. and Wang, C.J. (2017). On the risk prediction and analysis of soft information in finance reports. European Journal of Operational Research 257, pp. 243–250.

[10] Jans, M., Lubaert, N. and Vanhoof, K. (2010). Internal Fraud Risk Reduction: Results of a Data Mining Case Study. In: International Journal of Accounting Information Systems, 11(1). pp. 17-41.

[11] Argyrou, W. (2012). Auditing Journal Entries Using Self-Organizing Map. Proceedings of the Eighteenth Americas Conference on Information Systems.

[12] Evermann, J., Rehse, JR. and Fettke, P. (2017). A Deep Learning Approach for Predicting Process Behaviour at Runtime. In: Dumas, M., Fantinato, M. (eds) Business Process Management Workshops. BPM 2016. Lecture Notes in Business Information Processing (281)

[13] Schreyer, M., Sattarov, T., Borth, D., Dengel, A.R., and Reimer, B. (2017). Detection of Anomalies in Large Scale Accounting Data using Deep Autoencoder Networks. ArXiv, abs/1709.05254.

[14] Schreyer, M., Sattarov, T., and Borth, D. (2021). Multi-view contrastive self-supervised learning of accounting data representations for downstream audit tasks. Proceedings of the Second ACM International Conference on AI in Finance.

[15] Schreyer, M., Sattarov, T., and Borth, D. (2022). Federated and Privacy-Preserving Learning of Accounting Data in Financial Statement Audits. Proceedings of the Third ACM International Conference on AI in Finance.

[16] Schreyer, M., Sattarov, T., Gierbl, A.,Reimer ,B. and Borth, D. (2020). Proceedings of the First ACM International Conference on AI in Finance (45). pp. 1–8.

[17] Kish, L. (1965). Survey Sampling. John Wiley and Sons inc.

[18] Public Company Accounting Oversight Board (PCAOB). (2016). Audit Sampling. AS 2315.